Questo articolo può contenere link di affiliazione. ServerDiCasa partecipa al Programma Affiliazione Amazon EU, un programma di affiliazione che consente ai siti di percepire una commissione pubblicitaria pubblicizzando e fornendo link al sito Amazon.it.
Ogni volta che dimenticavo una porta, un percorso o un valore di configurazione dell’homelab finivo per fare la stessa cosa: aprire una connessione SSH e grepparmi un docker-compose.yml da centinaia di righe. Funziona, ma è lento, e dopo il log-digest — il primo strumento della serie IA locale passato davvero in produzione — mi sono chiesto se un modello locale potesse rispondermi direttamente, leggendo la configurazione vera invece di farmela ricordare a memoria.
Questo articolo non è un tutorial teorico su “come si costruisce un RAG”. È il racconto di tutto quello che si è rotto quando l’ho fatto usare davvero, da un bot Telegram, contro dati reali e domande vere — non i casi puliti che si scrivono a tavolino per un test.
Da dove sono partito, e la prima sorpresa
L’obiettivo era semplice da dire: un chatbot che risponde a domande sull’homelab leggendo la configurazione reale, non gli articoli del blog. La prima sorpresa è arrivata subito, ancora prima di scrivere codice: l’unico documento strutturato che avevo era il docker-compose.yml dei quindici servizi. Nessuna cartella di documentazione separata, nessun README interno. Il primo problema non era tecnico — era decidere cosa indicizzare, partendo da quasi niente.
Durante questa ricognizione ho trovato anche qualcosa che non stavo cercando: due segreti scritti in chiaro dove non dovevano essere, mentre le variabili corrispondenti esistevano già (mai collegate) in un file .env dedicato. È materiale per un articolo a sé — e infatti ne è nato uno, che esce su questo blog pochi giorni dopo questo: “Ho trovato password in chiaro nel mio docker-compose” — qui basti sapere che li ho sistemati prima di indicizzare qualsiasi cosa.
Perché due modelli residenti insieme, non in sequenza
Un RAG ha bisogno di due modelli: uno che trasforma il testo in vettori numerici (embedding) e uno che genera la risposta in linguaggio naturale (la chat). La scelta ovvia sembrerebbe farli girare in sequenza, scaricando l’uno per caricare l’altro. L’ho scartata subito: con 2 GB di VRAM, due modelli che si scaricano a vicenda significano pagare un caricamento a freddo della chat — quasi 4 secondi misurati — a ogni singola domanda.
Ho scelto invece di tenerli entrambi residenti insieme, accettando un costo diverso: meno VRAM disponibile per la chat, quindi meno layer del modello sulla GPU, quindi qualche token al secondo in meno in generazione. Per l’embedding ho scelto nomic-embed-text: piccolo (274 MB, 768 dimensioni), circa 370 MB di VRAM da solo.
Ho poi mappato l’intero intervallo utile di layer GPU per la chat convivendo con questo modello residente, e scelto il punto che lasciava un margine libero ancora comodo, pagando in cambio un po’ di velocità di generazione rispetto alla chat da sola. Con la configurazione attuale, misurata con i due modelli residenti insieme, la scheda riporta 1456 MiB occupati e 536 liberi sui 2048 totali: poco più di un quarto di margine. (I due numeri non fanno 2048 perché una parte della memoria resta riservata al driver e non è mai disponibile.) Il conto è semplice: perdere un quinto della velocità di generazione è accettabile, ricaricare un modello ad ogni domanda no. Quando ho fatto questa misura, la chat girava ancora su qwen2.5:3b-instruct-q8_0: dal 26 agosto la produzione è passata a granite4.2:3b, stesso num_gpu 15 (vedi «La configurazione in produzione», più sotto) — il compromesso VRAM/velocità non è stato rimisurato su questo modello.
Il log-digest notturno, che gira come processo separato una volta a notte, resta sulla sua configurazione originale — non condivide VRAM con niente, non ha bisogno di questo compromesso.
Due dettagli che sembrano piccoli e non lo sono
Prima di scrivere una riga del codice di indicizzazione ho controllato le istruzioni ufficiali del modello di embedding, non fidandomi della documentazione di Ollama (che qui non le riporta). nomic-embed-text vuole due prefissi diversi a seconda che tu stia indicizzando un documento o formulando una domanda — un dettaglio che, se saltato, degrada silenziosamente la qualità del recupero senza che nulla vada in errore. L’ho corretto prima ancora di misurare la prima query.
Il secondo dettaglio riguarda la temperatura della chat. Con le impostazioni più “creative” tipiche di un assistente in chat, il modello si comportava in due modi diversi e sbagliati a seconda del valore:
- Temperatura intermedia: si rifiutava di dedurre un’informazione implicita da un valore di configurazione quando la risposta richiedeva un piccolo passo logico invece di una copia letterale.
- Temperatura di default: la stessa identica domanda dava una risposta diversa a ogni run — a volte corretta, a volte no — per puro campionamento casuale.
- Temperatura zero (deterministico, “greedy”): risposta corretta e identica su più run consecutivi.
Per un assistente che deve rispondere in modo affidabile a domande tecniche, il campionamento casuale è un difetto, non una qualità.
Cosa indicizza, e come è cresciuto
La prima versione indicizzava solo il docker-compose.yml, spezzato in 16 blocchi (chunk). L’ho estesa quasi subito a sei fonti diverse — configurazione e automazioni di Home Assistant, override di sistema per Ollama, configurazione del broker MQTT, crontab utente — arrivando a 31 chunk totali. Ogni fonte aggiunta ha portato con sé un problema nuovo, ed è il motivo per cui questa sezione è più corta della prossima: il contenuto che indicizzi conta meno di come lo cerchi dopo.
Filtrare il rumore prima di rispondere
Recuperare i tre chunk più simili a una domanda, per coseno, sembra la scelta ovvia — ed è quella che ho implementato per prima. Il problema è arrivato con la prima domanda su un servizio poco documentato: il secondo e terzo chunk recuperati erano solo vagamente affini, rumore che il modello doveva comunque leggere e ignorare da solo.
Ho aggiunto una soglia relativa, non un numero fisso: un chunk sopravvive solo se il suo punteggio è almeno l’85% del migliore trovato per quella domanda specifica — il valore assoluto del coseno varia troppo da domanda a domanda per usare una soglia fissa, con un pavimento di sicurezza sotto il quale nessun chunk entra comunque. Sulle domande di riferimento che uso per verificare ogni modifica, il taglio ha eliminato il rumore genuino senza mai scartare un chunk davvero pertinente — verificato caso per caso, non per fiducia.
Dopo la soglia c’è un secondo filtro: un passaggio di reranking, dove lo stesso modello di chat giudica ogni chunk superstite chiedendosi se aiuta davvero a rispondere, non solo se è affine per argomento. Qui ho trovato un bug nella mia stessa logica: quando il modello rispondeva “nessuno dei candidati è utile”, il codice interpretava quella risposta come un fallimento di parsing e — per sicurezza — teneva tutti i candidati. L’esatto contrario di quello che doveva succedere. Corretto distinguendo i due casi, e ammorbidendo il criterio di giudizio da “deve contenere il dato esatto” a “deve aiutare anche solo indirettamente” — la versione severa scartava candidati genuinamente utili solo perché non mostravano il valore finale in chiaro.
I sei problemi trovati testando dal bot vero
Tutto quello che ho descritto finora ha superato i test che avevo scritto io. È testandolo davvero, dal bot Telegram, con domande che non avevo preparato in anticipo, che sono emersi i problemi veri.
1. Sintassi crontab letta male. Un orario scritto nel formato standard a cinque campi veniva interpretato in modo sbagliato — il modello non conosceva bene la convenzione. Risolto aggiungendo una spiegazione del formato nel prompt, solo quando il contesto recuperato contiene effettivamente una riga di crontab.
2. Il divario tra chiavi tecniche e domande in italiano. Una domanda su quanti giorni di storico tiene un servizio non recuperava affatto il chunk giusto, nonostante il dato ci fosse: troppa distanza tra la chiave di configurazione in inglese e la formulazione della domanda in italiano. Risolto aggiungendo un “gloss” — una descrizione in linguaggio naturale generata dal modello stesso — usato solo per calcolare l’embedding, mai mostrato nella risposta finale: rischiava di introdurre imprecisioni proprie nel testo che il modello avrebbe letto per rispondere.
3. Un servizio che restava invisibile nonostante il gloss. Con quindici servizi che condividono gran parte della struttura YAML, il poco testo distintivo di ciascuno veniva diluito dal boilerplate comune. Risolto estendendo il gloss a tutti i servizi, non solo a una selezione ristretta.
4. Un’allucinazione per omonimia. Due sistemi di backup completamente diversi condividono nel mio homelab la stessa parola generica nel nome. Il modello ha fuso i dettagli tecnici dell’uno in una risposta presentata come se riguardasse l’altro — inventando, di fatto, una configurazione che non esiste. Risolto con un’istruzione esplicita nel prompt: non fondere mai dettagli di servizi diversi anche se condividono una parola chiave.
5. Un reranking incoerente. Il primo tentativo chiedeva al modello un giudizio comparativo unico su tutti i candidati insieme — un compito troppo complesso per un modello da 3 miliardi di parametri: la stessa domanda, sullo stesso identico contesto, dava risposte diverse a run separati. Riscritto per chiedere un giudizio indipendente, sì/no, per ogni singolo candidato — un compito più semplice e molto più stabile.
6. Un secondo formato di data non riconosciuto. Il fix del problema 1 copriva solo il formato standard a cinque campi. Un servizio ne usa uno diverso, con i secondi inclusi. Esteso il suggerimento nel prompt a entrambi i formati.
Verificato dopo ogni correzione su un set fisso di domande di riferimento: nessuna regressione sui casi che già funzionavano.
L’aggiornamento che non serve toccare
L’indice si aggiorna da solo, senza che io debba lanciare niente a mano. Un controllo economico via crontab, ogni cinque minuti, calcola l’hash dei file sorgente e reindicizza solo se qualcosa è davvero cambiato — silenzioso quando non c’è nulla di nuovo, invece di un log a vuoto ogni cinque minuti.
L’ho testato su due fonti diverse per assicurarmi che il meccanismo non dipendesse da dettagli di un singolo caso: modificando a mano il docker-compose.yml (rilevato e reindicizzato in circa 6 secondi), e creando un’automazione fittizia dalla vera interfaccia web di Home Assistant — un file di proprietà dell’utente di sistema, non scrivibile via SSH con il mio utente normale. L’aggiornamento automatico l’ha rilevata comunque: gli basta il permesso di lettura, non quello di scrittura.
L’aggiornamento automatico ha un difetto, e l’ho scoperto dopo
La sezione qui sopra l’ho scritta convinto che l’aggiornamento automatico fosse la parte più tranquilla di tutto il sistema. Si è rivelata la meno tranquilla, per un motivo che davo per scontato senza averlo mai verificato.
Rigenerare l’indice non è un’operazione neutra. Non ricostruisce la stessa cosa che c’era prima: ne costruisce una leggermente diversa, ogni volta.
Il motivo sta nei gloss, le descrizioni in linguaggio naturale che il modello scrive per ogni blocco di configurazione e che finiscono solo dentro il calcolo del vettore, mai nella risposta. Li ho messi perché servivano davvero — senza, una domanda in italiano non trovava un blocco pieno di chiavi YAML in inglese. Ma sono scritti da un modello, e un modello, su questa macchina, non produce due volte lo stesso testo.
L’ho misurato nel modo più stupido possibile: stesso blocco di configurazione, stesso modello, stessa temperatura, tre giri di fila.
| giro | lunghezza | come descrive Pi-hole |
|---|---|---|
| 1 | 291 caratteri | «…per gestire il DNS e proteggere i dispositivi da pubblicità» |
| 2 | 319 caratteri | «…per gestire il DNS e la sicurezza dei dispositivi in casa» |
| 3 | 319 caratteri | identico al secondo |
Più su ho scritto che a temperatura zero la stessa domanda dava una risposta identica su più run consecutivi. Quella osservazione è vera, ed è ancora lì: la temperatura zero toglie il campionamento casuale, cioè il dado che il modello tira per scegliere la parola successiva. Quello che non fa — e che avevo dato per implicito scrivendo «deterministico» fra parentesi — è rendere riproducibile tutto il resto. Su questo hardware due esecuzioni della stessa identica chiamata possono divergere lo stesso.
E un gloss diverso è un vettore diverso. Un vettore diverso è un ordinamento diverso fra i blocchi candidati. Un ordinamento diverso è, a valle, una risposta diversa.
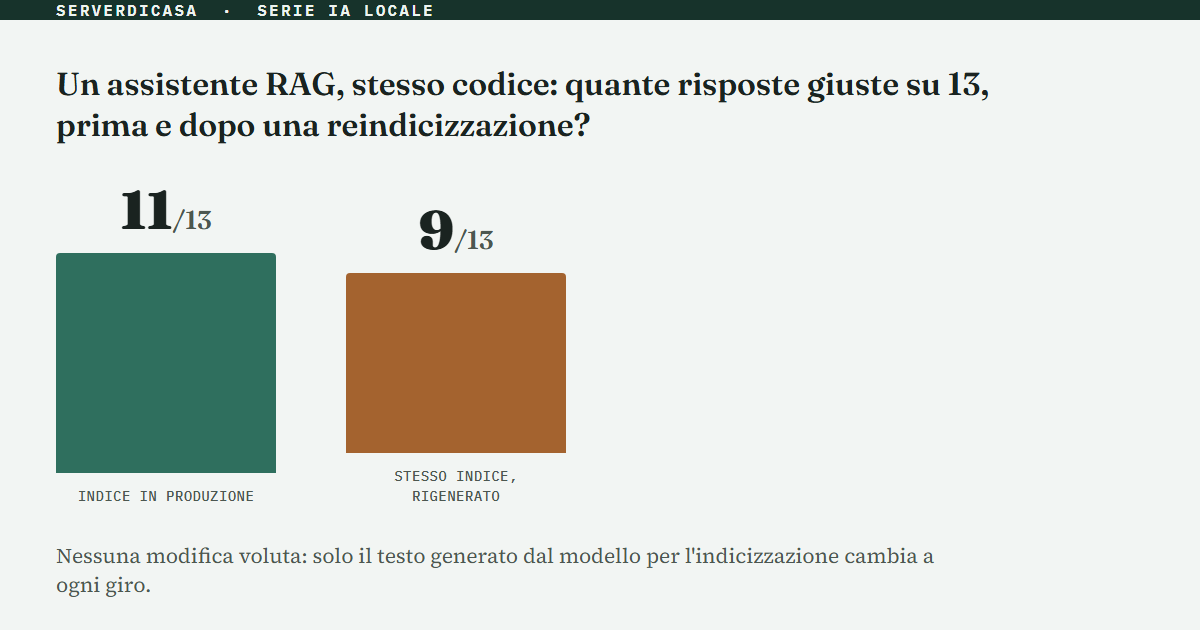
Quanto diversa, l’ho misurato con un banco di 13 domande a risposta nota. L’indice in produzione ne azzecca 11 su 13. Rigenerandolo — stesso codice, stesso modello, nessuna modifica voluta — scende a circa 9 su 13. Due volte su due. Le domande che si rompono non sono sempre le stesse: in un giro ha smesso di sapere su che porta risponde Duplicati, in un altro ha risposto che il fuso orario dei container è «le quattro di mattina di ogni domenica».
Rimesso a posto l’indice precedente, le risposte tornano quelle giuste. Il problema non è la qualità di una singola generazione: è che la qualità è un tiro di dado che si rifà a ogni reindicizzazione.
Il che riqualifica la sezione precedente. «L’aggiornamento che non serve toccare» descrive esattamente il meccanismo — l’hash funziona, i sei secondi sono quelli, il rilevamento è affidabile — ma è la frase più sbagliata dell’articolo sul significato. Quel controllo ogni cinque minuti non è una comodità che gira in sottofondo: è la cosa che, la notte in cui modifico un docker-compose.yml per un motivo qualsiasi, rimescola le risposte dell’assistente senza scrivere una riga da nessuna parte. Nessun errore, nessun log, nessun exit code diverso da zero. Solo un assistente che da domani risponde un po’ peggio, o un po’ meglio, e non lo sa nessuno.
È lo stesso identico difetto raccontato in cima a questo articolo, quello che mi era costato giorni: un guasto che non fallisce, peggiora e basta. Solo che stavolta era nella parte che credevo finita.
Cosa ho fatto, e cosa va fatto
Nell’immediato, la cosa che costa cinque righe: l’aggiornamento automatico ora salva una copia datata dell’indice prima di rigenerarlo, e ne tiene le ultime cinque. Non risolve niente — rende il danno reversibile. Se dopo un cambio di configurazione l’assistente risponde peggio, si torna indietro con un comando invece di accorgersene fra tre settimane senza più l’originale.
La soluzione vera è un’altra, e non l’ho ancora scritta: mettere in cache i gloss, salvandoli insieme all’impronta del blocco da cui vengono, e rigenerarli solo per i blocchi davvero cambiati. Una reindicizzazione toccherebbe uno o due vettori invece di trentuno, l’indice tornerebbe riproducibile, e come effetto collaterale l’operazione passerebbe da una ventina di minuti a pochi secondi.
La lezione generale, che vale ben oltre questo assistente: se un pezzo della tua pipeline è generato da un modello, quel pezzo è un artefatto da conservare, non da ricostruire. Rigenerarlo «senza cambiare niente» cambia qualcosa.
Cosa non ho ancora verificato
Non l’ho testato su domini più complessi, con più strumenti richiesti in contemporanea nella stessa domanda. E su questo hardware la latenza delle chiamate del modello durante l’indicizzazione è imprevedibile in un modo che non sono riuscito a spiegare fino in fondo: lo stesso identico compito, isolato, ha impiegato una manciata di secondi; durante un giro dal vivo, con altri processi attivi, è arrivato a diversi minuti — senza segni di surriscaldamento verificabili. È un limite noto dell’hardware di questa macchina, non qualcosa che ho risolto.
La configurazione in produzione
Embedding: nomic-embed-text (274 MB, 768 dim)
Chat: granite4.2:3b, num_gpu 15
Script: /opt/homeserver/scripts/rag/
  rag-build-chunks.py, rag_core.py, rag-index.py,
  rag-query.py, rag-telegram-bot.py (+ servizio systemd)
Reindicizzazione: rag-autoindex.py via crontab utente, */5 * * * *
Vale la pena farlo sul proprio homelab?
Dipende da quanto la tua configurazione è sparsa su più file e servizi diversi. Se hai già tutto ben documentato in un posto solo, un RAG aggiunge complessità per un problema che non hai. Se invece — come il mio caso — la configurazione vive in mezza dozzina di file diversi, mai riletti tutti insieme, avere qualcosa che risponde in linguaggio naturale senza dover aprire SSH ogni volta vale il tempo speso a farlo funzionare bene.
Un limite da tenere a mente: questo disegno regge un uso personale, con domande sporadiche una alla volta. Non è pensato per rispondere a più persone insieme — i due modelli residenti coprono un utilizzo, non un carico concorrente.
Domande frequenti
Cos’è un RAG e a cosa serve in un homelab?
RAG (Retrieval-Augmented Generation) è una tecnica che recupera i pezzi di testo più pertinenti a una domanda da un archivio di documenti, e li passa a un modello linguistico come contesto per generare la risposta. In un homelab serve a interrogare la propria configurazione tecnica in linguaggio naturale, senza dover cercare a mano nei file.
Quanta VRAM serve per un RAG locale con Ollama?
In questo caso, circa 2 GB in totale per tenere residenti insieme un modello di embedding leggero e un modello di chat da 3 miliardi di parametri con un numero ridotto di layer sulla GPU. Con più VRAM disponibile si può permettere sia più layer sulla chat sia un modello di embedding più grande.
Un RAG locale funziona anche su hardware vecchio o economico?
Sì, ma con dei compromessi da accettare consapevolmente: meno VRAM significa meno layer sulla GPU e quindi risposte più lente, e va scelto con cura come dividere la memoria disponibile tra i due modelli che servono contemporaneamente.
Conclusione
Il pattern che continua a ripetersi in questa serie: la parte facile è far girare qualcosa che funziona sui casi che hai scritto tu. La parte che vale la pena raccontare è tutto quello che si rompe quando lo usi per davvero, con domande che non ti aspettavi. Sei problemi diversi, tutti trovati dal bot vero e non da un test unitario — e probabilmente non sono gli ultimi.
Nasce dalla stessa sessione di lavoro sull’IA locale che ha prodotto gli articoli su num_gpu e sulla quantizzazione del modello — un tool nuovo costruito da zero, non un tuning di configurazione come quei due, ma stessa area tematica.
L’ultimo problema, arrivato mentre questo articolo era in coda
Ci ho messo poco a essere smentito sul «non sono gli ultimi»: ne sono saltati fuori altri due, lo stesso giorno. Uno l’hai già letto qui sopra — l’indice che si rimescola da solo a ogni rigenerazione. L’altro è questo, ed è il più istruttivo di tutti — perché per giorni non è sembrato affatto un problema.
Provando a sostituire il modello di chat con uno più recente, ogni singola domanda andava in timeout. Non qualche domanda: tutte, e sempre dopo lo stesso identico tempo. La lettura istintiva era quella sbagliata e comodissima: l’hardware non ce la fa, il modello nuovo è troppo grosso per una scheda da 2 GB. Stavo per archiviarlo così.
Il numero mi ha salvato. Il timeout era di 270 secondi esatti, che è una somma sospetta: 3×60 secondi dei tre giudizi di reranking, più i 90 della risposta finale. Ogni singola chiamata al modello stava esaurendo il proprio tempo massimo, non stava andando piano. E un modello che non risponde mai, sempre allo stesso modo, non è un modello lento: è un modello che sta facendo altro.
Stava ragionando. I modelli più recenti hanno una modalità di ragionamento attiva di default, e vanno spenti esplicitamente passando "think": false nella chiamata. Il mio codice non lo passava. Con i modelli della generazione precedente non se ne accorgeva nessuno, perché quella modalità semplicemente non ce l’avevano: l’assistente funzionava per caso, e avrebbe smesso di funzionare al primo aggiornamento del modello.
La lezione non è la riga di codice, è la forma del guasto. Questo bug non dava errore. Non compariva nei log, non alzava un’eccezione, non scriveva niente da nessuna parte: si presentava come lentezza, cioè come un limite dell’hardware. È la categoria di problema più pericolosa in un progetto casalingo, perché la conclusione sbagliata — «serve una scheda migliore» — è anche quella che costa di più e che nessuno mette in dubbio.
Sistemato quello, il modello nuovo non solo funziona: risponde correttamente a 12 domande su 13 di un banco di prova, contro le 9 su 13 del modello che avevo prima — la prima misura della giornata, appena installata la correzione. Rifacendo lo stesso banco più tardi, sullo stesso indice di produzione, senza toccare altro: 11 su 13, il numero citato più sopra in «L’aggiornamento automatico ha un difetto». Stesso indice, due misure a poche ore di distanza, due risultati diversi. Fra le tre che sbagliava, una era «a che ora gira il backup»: leggendo 0 3 * * * rispondeva «alle quattro del pomeriggio», con la sicurezza di chi ha letto il file giusto. Su un assistente che risponde sulla tua infrastruttura, è il tipo di errore peggiore che ci sia.
Nota: alcuni dettagli sono generalizzati dove riportano nomi di servizi o valori di configurazione specifici del mio homelab — la sostanza tecnica, i numeri e il funzionamento restano quelli reali, verificati sui log e sul comportamento effettivo del sistema.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.