Negli ultimi articoli ho misurato se un’IA locale su hardware di recupero può girare: quanto conta il processore, quanta RAM serve, quanta VRAM, quanto è affidabile nel chiamare uno strumento. Questo è il primo pezzo della serie che racconta cosa ci ho costruito sopra — e parte da un’ammissione che vale la pena fare subito, perché cambia tutto il resto: i guasti più interessanti di questa storia non li ha trovati l’IA. Li ho trovati io, a mano, prima ancora di scrivere una riga dello script.
Il motivo per cui vale comunque la pena raccontarla è quello che ho costruito dopo, per non doverlo rifare a mano la prossima volta.
Due buchi diversi, non uno
Sul mio homelab Uptime Kuma mi avvisa se un servizio va giù. Un controllo sul disco mi avvisa se lo spazio finisce. Sono due allarmi utili, ma coprono solo i guasti che fanno rumore: un processo che crasha, una soglia che si supera.
Ce n’è un secondo tipo che non fa scattare niente per definizione: la configurazione sbagliata da mesi che non produce mai un errore, perché semplicemente fa in silenzio la cosa sbagliata. Una passphrase di backup diversa da quella che credi, una cartella dimenticata fuori da un job, un file di configurazione scritto e mai davvero applicato. Nessuno di questi eventi scrive una riga di log: non c’è niente da intercettare, perché tecnicamente non sta succedendo nessun errore.
Ho passato tre giorni, dal 31 luglio al 2 agosto, ad aprire una cosa alla volta per cercare esattamente questo tipo di guasto. A mano. E ne ho trovati otto.
Cosa ho trovato durante l’audit manuale
In ordine di gravità, non cronologico.
Il più serio: il backup automatico non era ripristinabile. La passphrase che credevo corretta non apriva l’archivio — probabilmente Duplicati ne aveva generata una diversa durante una configurazione passata, e da allora 22 punti di ripristino erano di fatto inaccessibili. Senza controllarlo a mano l’avrei scoperto solo provando a ripristinare qualcosa per davvero, nel momento peggiore possibile.
Sette cartelle su quindici non finivano nel backup. Tra queste, i dati di configurazione di Pi-hole, Home Assistant, Uptime Kuma e del pannello di gestione container — servizi che uso ogni giorno e che avrei dovuto ricostruire da zero in caso di guasto disco.
Una cartella di configurazione dell’host scriveva ogni notte in un percorso che il job di backup non guardava affatto: veniva prodotta, e persa, ogni giorno, senza che nessun processo fallisse.
Un file di configurazione DNS scritto settimane prima per disattivare la risoluzione IPv6 non era mai stato effettivamente applicato: l’impostazione che doveva attivarlo era rimasta disattiva.
Una scoperta collaterale un po’ bizzarra: uso in casa un dominio locale fittizio che finisce con un’estensione a due lettere — solo che quell’estensione è anche un TLD pubblico reale registrato su Internet. Uno dei miei sottodomini locali, digitato per errore fuori dalla rete di casa, risolveva su un host reale registrato all’estero invece che fallire e basta. Innocuo nel mio caso, ma un promemoria che i domini “finti” usati in LAN non sono davvero neutri.
Un servizio di monitoraggio puntava a un indirizzo di rete interno sbagliato — probabilmente cambiato durante un aggiornamento — e da settimane non stava controllando niente, pur risultando “attivo” nella sua interfaccia.
Un hostname mancante dai record DNS locali, che rendeva irraggiungibile un servizio con il nome comodo che uso di solito.
L’ottavo, il più istruttivo: lo script che tengo per sapere se la connessione a Internet è caduta registrava le disconnessioni al contrario. L’evento scattava solo quando falliva anche il gateway del router — cioè un guasto totale della mia rete di casa. Risultato: i disservizi dell’operatore, quelli che davvero volevo intercettare (dove il gateway resta raggiungibile ma Internet no), non venivano mai registrati, mentre finivano nel log solo i blackout completi della rete locale. L’esatto opposto di quello che serviva.
Nessuno di questi otto ha mai prodotto una riga di errore in un log. È esattamente per questo che è sopravvissuto: non c’era niente da intercettare, solo qualcosa da controllare a mano.
Perché ho costruito uno strumento comunque
A questo punto la domanda onesta è: se questi guasti li trovi solo aprendo le cose una alla volta, a cosa serve un LLM che legge i log?
Serve a un problema adiacente, diverso: l’errore che si ripete ogni notte nei log e che nessuno legge mai, non perché sia invisibile come i guasti di configurazione, ma perché sepolto in centinaia di righe che nessuno ha voglia di scorrere. Un container che fallisce la stessa richiesta da giorni, un login sbagliato ripetuto, un errore hardware isolato: sono già scritti da qualche parte, il problema è che non li legge nessuno.
Per quello, un filtro di regole basta a trovarli. Il modello serve a un secondo compito: riscriverli in italiano leggibile e distinguere quello che è nuovo da quello che si ripete uguale da giorni, così la notifica che ricevo non è un muro di log grezzi.
Come è disegnato: il modello non decide, riscrive
Il punto tecnico centrale, e vale la pena essere espliciti perché è controintuitivo dopo un articolo sul tool calling: qui il modello non chiama nessuno strumento, non agisce su niente. Il disegno ha quattro pezzi:
- Un filtro deterministico scansiona tre fonti — i log dei container delle ultime 24 ore,
journalctla priorità 3 (errore) o superiore, e l’elenco dei servizi falliti di systemd — cercando righe che matchano un set di pattern definiti a mano, e deduplica per “firma”: righe che si ripetono con lo stesso pattern contano come un evento solo, non uno a riga. - Solo le novità arrivano al modello. Ogni notte si confrontano le firme di oggi con quelle già viste. Se non c’è niente di nuovo, il modello non viene nemmeno chiamato.
- Il modello riscrive in italiano quello che il filtro gli ha passato: non decide cosa è grave, non manda comandi a nessun servizio, non tocca file.
- Funziona anche senza il modello. Se Ollama non risponde, il messaggio parte comunque con l’elenco grezzo delle firme nuove.
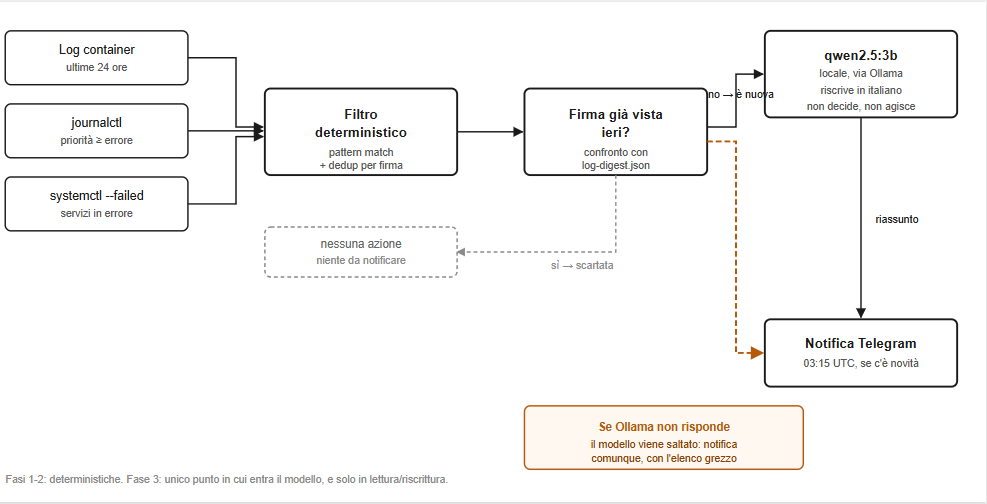
Un limite strutturale del punto 1, ed è importante dirlo: il filtro vede solo ciò che produce una riga in una di quelle tre fonti. Tutto ciò che è un errore di configurazione silenzioso — come gli otto trovati durante l’audit — resta invisibile per costruzione, oggi come il primo giorno. Non è un bug da correggere: è il confine dichiarato di cosa questo strumento può fare.
È lo stesso principio di fondo dell’articolo sul tool calling: un modello piccolo va usato dove, se sbaglia, non succede niente di irreversibile. Qui l’input è lungo (i log grezzi), l’output è corto (un riassunto), e il modello non agisce mai — legge e basta.
La configurazione in produzione
/opt/homeserver/scripts/log-digest.py     cron root, 03:15 (UTC) ogni notte
/opt/homeserver/state/log-digest.json     stato (solo firme e conteggi)
modello: qwen2.5:3b, num_gpu 28, num_ctx 8192, temperature 0
Aggiornamento del 26 agosto 2026 — questa configurazione non è più quella in produzione, e a dire il vero non lo era già il giorno in cui questo articolo è uscito.
Due cambi, in ordine. Il 19 agosto sono passato a qwen2.5:3b-instruct-q8_0 con num_gpu 18: più lento (3,8 contro 7,6 token al secondo) ma molto più affidabile, e per un compito che gira una volta a notte senza nessuno a guardare la velocità non conta quasi niente. Il 26 agosto il digest è passato a granite4.2:3b, con num_ctx 4096, num_gpu 33 e num_thread 5.
E c’è un pezzo del ragionamento qui sotto che la misura ha smentito. Scrivevo che serviva un contesto di 8192 token perché i log di una notte intera occupano più spazio del prompt di un assistente. Per un banco di prova ho poi ricostruito 62 finestre dai log veri, e l’input più grande mai passato al modello è di 1177 token: dopo il filtro, i log di una notte sono corti. A num_ctx 4096 restano 3,3 volte di margine, e la VRAM che si libera porta i layer sulla scheda da 30 a 33 — cioè il contesto sovradimensionato mi stava costando velocità e basta. Il giro notturno è sceso da 40,6 a 29,2 secondi.
Quello che invece regge — e adesso ha un numero — è la tesi centrale di questo articolo: il lavoro pesante lo fa il filtro deterministico, non il modello. L’ho messa alla prova con 15 modelli su 27 casi ricostruiti dai log veri, e il risultato è più netto di quanto scrivessi qui. Sul giudizio di gravità nessuno dei 15 batte un pappagallo che risponde sempre «da guardare»: il migliore fa 11 su 27, la costante ne fa 14. E il 45% delle righe che mi arrivavano ogni notte era rumore per il mio stesso criterio. Ho tolto del tutto la classificazione di gravità dal prompt e allargato il filtro da 5 a 18 pattern, con un taglio del 31% delle righe. È materiale per un articolo a sé, che arriverà.
Un dettaglio a cui non avevo pensato finché non sono andato a controllare: il server tiene l’orologio di sistema in UTC, non nel fuso italiano dei container che ci girano sopra. Le 03:15 di cron sono, con l’ora legale di agosto, le 05:15 in Italia — non le 03:15 come avrei scritto istintivamente.
Un dettaglio che conta più del modello scelto: il modello non resta caricato in memoria. Ollama gira come servizio sempre attivo, ma carica il modello solo quando arriva la chiamata e lo scarica dopo 5 minuti di inattività. Una chiamata a notte, circa 30 secondi. Per il resto della giornata la VRAM è libera e la GPU è a zero. Non ho impostato OLLAMA_KEEP_ALIVE=-1 — la variabile che tiene il modello sempre residente: ha senso per un assistente in chat, non per 30 secondi al giorno.
Chi ha letto anche l’articolo sul tool calling noterà un numero diverso: lì avevo indicato num_gpu 29 con un contesto di 4096 token. Qui uso num_gpu 28 e un contesto doppio, 8192: i log di una notte intera occupano più spazio del prompt di un assistente, e un layer di GPU in meno lascia posto alla KV cache più grande di cui questo compito ha bisogno.
Nato, testato e messo in cron in ottanta secondi
Lo script è nato il 2 agosto alle 23:53:24. Trentadue secondi dopo, il primo test a mano. Quarantotto secondi ancora dopo, la riga di cron era già installata. Scritto, provato e messo in produzione nell’arco di un caffè, poco prima di mezzanotte — l’audit manuale che aveva trovato gli otto guasti era già chiuso da ore.
Il primo giro davvero autonomo, via cron, è scattato la notte dopo: 3 agosto, 03:15 UTC. Ha registrato 30 firme distinte su 6 fonti diverse. Ma con lo stato ancora vuoto, lo script considera “nuovo” tutto ciò che trova — è un censimento della situazione di partenza, non una scoperta. Tra quelle 30 firme c’erano comunque cose reali già presenti nei log in quei giorni: un paio di errori hardware corretti automaticamente e isolati (ora sotto un monitoraggio dedicato), un job di sincronizzazione tra Prowlarr e Radarr che falliva silenziosamente con un errore di richiesta malformata (400 BadRequest), una cinquantina di tentativi di login falliti su Home Assistant da un dispositivo della mia stessa rete, e un sensore Shelly che aveva smesso di rispondere. Il segnale utile — solo ciò che è davvero nuovo rispetto al giorno prima — comincia dalla seconda notte.
Da allora il cron non ha saltato una sera: 14 giorni pieni, 15 esecuzioni, fino a stanotte. L’unica interruzione è stata un riavvio del server tra il 12 e il 13 agosto — il servizio è ripartito da solo la notte successiva, senza bisogno di intervenire.
Un bug trovato scrivendo questo stesso articolo
Volevo un output vero da mostrare, così ho lanciato un --dry-run mentre scrivevo. È uscito questo: 19 nuovi, 0 in peggioramento — e più della metà erano righe di Syncthing che segnalavano una disconnessione da un dispositivo, ripetuta nove volte in poche ore. Il riassunto del modello le ha lette come “Syncthing ha perso connessione con diversi dispositivi, probabilmente a causa di problemi di rete o SSL”.
Falso su entrambi i fronti. Era un solo dispositivo — il telefono che si addormenta e si riconnette cambiando indirizzo — nove volte, non “diversi”. E l’SSL non c’entrava niente con Syncthing: il modello l’aveva preso da un’altra riga, quella di Prowlarr che non riusciva a raggiungere un indicizzatore, e l’aveva cucito addosso all’incidente sbagliato. Non ha inventato dal nulla: ha fuso due guasti scollegati in una storia sola, che è esattamente il modo in cui questi modelli sbagliano quando gli passi un elenco eterogeneo senza dirglielo.
Ma il problema vero non era il riassunto: era arrivato fin lì perché il filtro sotto aveva già fallito in due modi.
Primo: IGNORA non intercettava Syncthing. La regola esistente cercava level=INFO, ma Syncthing scrive INF. Le sue righe di riconnessione — normalissime, un telefono che cambia rete non è un guasto — passavano il filtro INTERESSANTI perché contengono letteralmente la parola error dentro un campo error="..." che in realtà descrive solo il motivo tecnico della disconnessione, non un errore vero.
Secondo, più subdolo: le firme non collassavano. Ogni riconnessione porta un identificativo di sessione generato al volo — lettere e cifre miste, non esadecimale puro. La regola che riduce i numeri a un simbolo neutro non lo toccava, quindi ogni riconnessione produceva una firma diversa dalla precedente. Nessuna delle due notti si assomigliava mai, e la promessa centrale del sistema — “segnalo solo le novità” — si stava degradando esattamente nel modo descritto in cima allo script: verso un messaggio quotidiano che si impara a ignorare.
Due correzioni, non una riscrittura: un pattern in più in IGNORA per le disconnessioni Syncthing verificate come rumore normale, e una regola in più in normalizza() che cattura gli identificativi misti lettere-cifre di 8 caratteri o più prima che i numeri vengano ripuliti.
Prima di installare qualcosa ho voluto un numero, non solo una sensazione. Ho scritto un secondo script, di sola lettura, che riusa lo stesso codice di raccolta e conta quante righe sopravvivono a ogni fase del filtro — con le regole vecchie e con quelle nuove, sugli stessi identici log delle ultime 24 ore:
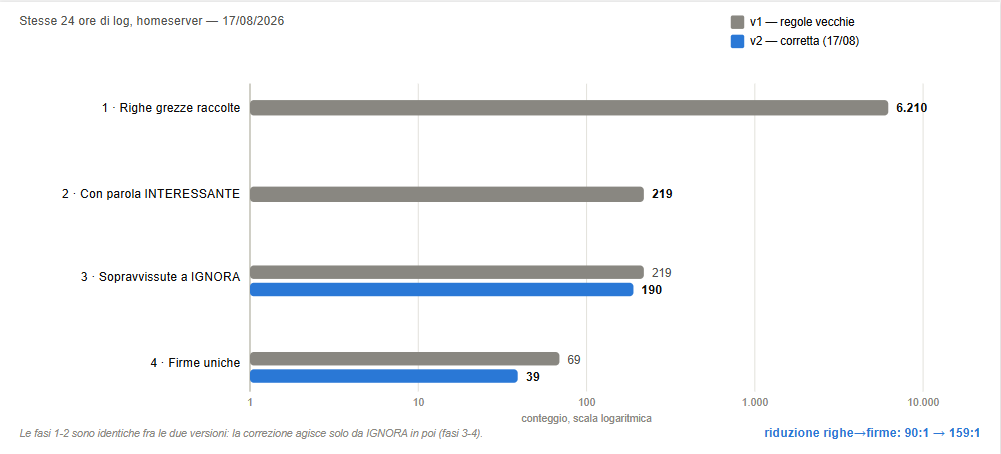
Le prime due fasi sono identiche per costruzione — il filtro INTERESSANTI non è cambiato. È dalla terza in poi che si vede l’effetto: 219 righe sopravvissute a IGNORA diventano 190, e il contributo di Syncthing da solo passa da 29 righe che generavano 29 firme diverse (zero deduplicazione: il bug nella sua forma più nuda) a zero, perché ora vengono scartate a monte come rumore noto. Il rapporto complessivo fra righe raccolte e firme uniche passa da 90 a 1 a 159 a 1.
Installato lo script corretto e resettato lo stato — passaggio obbligato: le firme sono hash del testo normalizzato, quindi cambiare normalizza() invalida tutti gli hash di ieri. Senza reset, la notte successiva avrebbe segnalato di nuovo tutto come “nuovo”, vanificando la correzione. Il reset di stasera ha registrato 39 firme in 8 origini — lo stesso numero previsto dalla misura di sola lettura, un controllo di coerenza che non mi aspettavo ma che non guasta.
C’è una lettura più larga di questo episodio. Gli otto guasti dell’audit manuale non lasciavano traccia: bisognava aprire le cose una a una per trovarli. Questo bug, invece, lasciava traccia nel proprio output — bastava leggere un --dry-run con attenzione per notarlo. È la differenza pratica fra un sistema che fallisce in silenzio assoluto e uno che fallisce rumorosamente ma in un posto che, se non guardi, resta comunque silenzioso. Il filtro può sbagliare tanto quanto una configurazione dimenticata; la differenza è che qui l’errore era misurabile, non solo scopribile per caso.
Il patto di spegnimento
L’ho deciso apposta mentre l’entusiasmo per il progetto era alto, per non tradirlo dopo: se dopo trenta notti smetto di leggere i digest, disinstallo tutto — modello, Ollama, driver GPU compresi. Oggi sono a 14 notti su 30. È il rischio più concreto di qualsiasi automazione “furba”: diventare un servizio che gira per conto suo e che nessuno guarda più.
Cosa non ci ho messo, e perché
Prima di arrivare al log-digest avevo in mente altre idee per usare il modello locale. Le ho scartate quasi tutte, ed è la parte che di solito non si legge in un articolo di homelab.
- Promemoria. Siri li fa in due secondi, sincronizzati su tutti i dispositivi, anche a server spento. Un sistema locale sarebbe oggettivamente peggiore su ogni fronte.
- Calendario. Si legge dal telefono, non serve un intermediario.
- Domotica diretta. Accendere luci o attuatori dall’app è già più veloce e affidabile di passare da un modello.
- Pulizia automatica dei file. Scartata senza appello: significherebbe dare a un modello che sui compiti strutturati sbaglia dal 30 al 70% dei casi il permesso di cancellare dati reali.
Il log-digest è sopravvissuto a questo filtro perché rispetta la regola che mi ero dato dopo i test sul tool calling: il modello legge, non agisce. Se sbaglia una riscrittura, il danno è zero.
Domande frequenti
Il log-digest trova anche errori di configurazione, non solo di log?
No, ed è importante dirlo chiaro: guarda solo tre fonti di log (container, journalctl, servizi falliti di systemd) e ne estrae solo le righe che matchano dei pattern definiti. Un guasto che non produce mai una riga d’errore — come una passphrase sbagliata o una cartella dimenticata fuori da un backup — gli resta invisibile per costruzione. Quel tipo di problema lo trovi solo con un audit manuale.
Serve un LLM per fare monitoraggio dei log, o basta uno script?
Per individuare gli errori basta uno script di regole — è quello che fa davvero il lavoro pesante in questo sistema. Il modello serve solo per riscrivere in italiano leggibile ciò che il filtro ha già isolato e per distinguere le novità dal rumore ricorrente. Senza il modello il sistema funziona comunque, solo con un elenco più grezzo.
Cosa succede se il modello o Ollama non rispondono?
Il digest arriva comunque, con l’elenco grezzo delle firme nuove invece del riassunto in italiano. È una scelta di disegno precisa: il pezzo che non deve mai fallire è l’allarme, non la sua forma leggibile.
Conclusione
La versione che avrei voluto raccontare — “ho acceso un’IA e alla prima notte ha trovato sette guasti” — non è quella vera, e vale la pena dirlo anche se è meno scenografica. La versione vera è divisa in due: un audit fatto a mano ha trovato otto guasti di configurazione silenziosi, del tipo che nessuno strumento automatico avrebbe potuto vedere. E uno strumento nato dopo, in ottanta secondi tra la scrittura e il primo cron, risolve un problema diverso e più piccolo — l’errore che si ripete nei log e che nessuno ha voglia di leggere — e lo fa da quattordici notti di fila senza saltarne una.
Non è la storia che l’IA ha trovato tutto da sola. È la storia di due strumenti diversi per due tipi di guasto silenzioso, e di quale dei due un modello locale può davvero occuparsi.
Quanto costa tenerlo acceso l’ho misurato dopo, alla presa: il conto completo è qui, e il riassunto di ogni notte pesa quattordici centesimi all’anno.
Nota: i dettagli sui guasti trovati sono generalizzati dove riportano indirizzi di rete o nomi interni specifici del mio homelab — i numeri, i timestamp e la sostanza tecnica restano quelli reali, verificati sui log e sui metadati dei file del server.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.