Dopo aver misurato processore, RAM e GPU, restava la domanda che conta davvero: su questo hardware ci si può far girare qualcosa di utile, o solo di dimostrativo?
Per rispondere ho dovuto cambiare metrica. E la scoperta più interessante è arrivata proprio da lì.
I token al secondo sono la metrica sbagliata
Tutti i benchmark di IA locale misurano la velocità di generazione. Per un assistente che deve fare cose è la misura sbagliata, per due motivi.
Il primo è che un agente è asincrono. Un framework come PicoClaw rilegge un file di stato ogni mezz’ora e reagisce a messaggi che arrivano quando arrivano. Se ci mette sette secondi invece di uno, non c’è nessuno a guardare il cursore lampeggiare.
Il secondo è decisivo. Un modello veloce che sbaglia una chiamata su tre è inservibile. Un modello lento che le azzecca sempre è ottimo. La variabile che decide è l’affidabilità del tool calling, cioè quanto è bravo a capire quale strumento invocare e con quali parametri.
Quasi nessuno la misura prima di montare tutto. Io l’ho fatto.
Come ho misurato l’affidabilità
Ho costruito quattro strumenti con uno schema realistico, del tipo che esporrebbe un assistente collegato alla domotica: accendere una luce con enum su stanza e stato, leggere un sensore, inviare un messaggio, cercare un film.
Sedici casi di prova, otto in italiano e otto in inglese. E qui la parte importante: due per lingua sono pura conversazione — “ciao come va”, “grazie mille” — dove la risposta giusta è non invocare nessuno strumento. Due ripetizioni per caso, temperatura a 0. Trentadue misure per modello.
Ho contato quattro cose separatamente, e il motivo di ciascuna conta:
- Chiamata davvero emessa, cioè un oggetto strutturato e non il JSON scritto dentro il testo della risposta. È la distinzione che i benchmark generici non fanno: il framework legge il campo strutturato, e un modello che “risponde bene a parole” per lui non ha risposto affatto.
- Funzione giusta e argomenti giusti, separati perché falliscono per ragioni diverse. Scegliere lo strumento sbagliato è un problema di comprensione; sbagliare i nomi dei parametri è un problema di aderenza allo schema, e il secondo si aggira riscrivendo le descrizioni.
- Falsi positivi: strumento invocato su una frase di cortesia.
L’ultima merita una colonna tutta sua, e il motivo è pratico: in un assistente sempre acceso collegato alla domotica, è l’errore che ti fa spegnere tutto dopo due giorni. Accende le luci perché gli hai detto buongiorno.
Un modello è fuori discussione
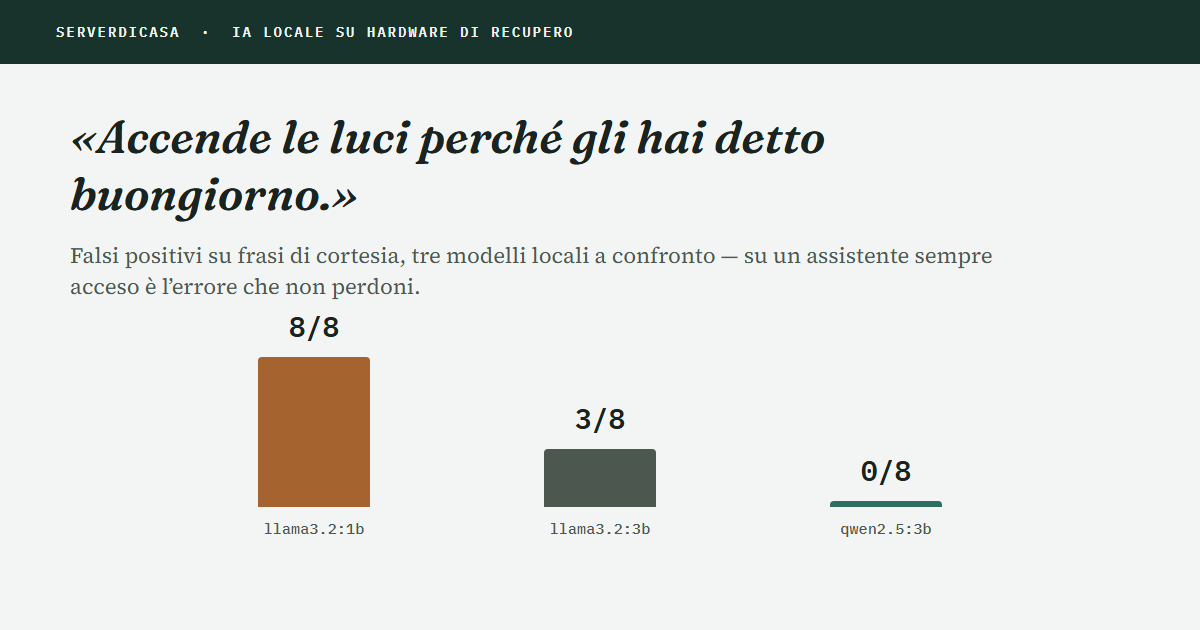
Partiamo dal risultato più netto. llama3.2:1b, il modello da 1,3 GB, ha invocato uno strumento su tutte e otto le frasi di cortesia, in entrambe le lingue. In due casi ha anche scritto il JSON nel testo invece di emettere una chiamata vera.
Non è un problema di prompt da sistemare: è troppo piccolo per il compito. Va escluso e basta.
Due modelli, stesso punteggio, errori opposti
| Modello | Esecuzione IT | Esecuzione EN | Falsi positivi | Globale |
|---|---|---|---|---|
| llama3.2:1b | 75,0% | 75,0% | 8 su 8 | 56,2% |
| llama3.2:3b | 100% | 100% | 3 su 8 | 90,6% |
| qwen2.5:3b | 91,7% | 83,3% | 0 su 8 | 90,6% |
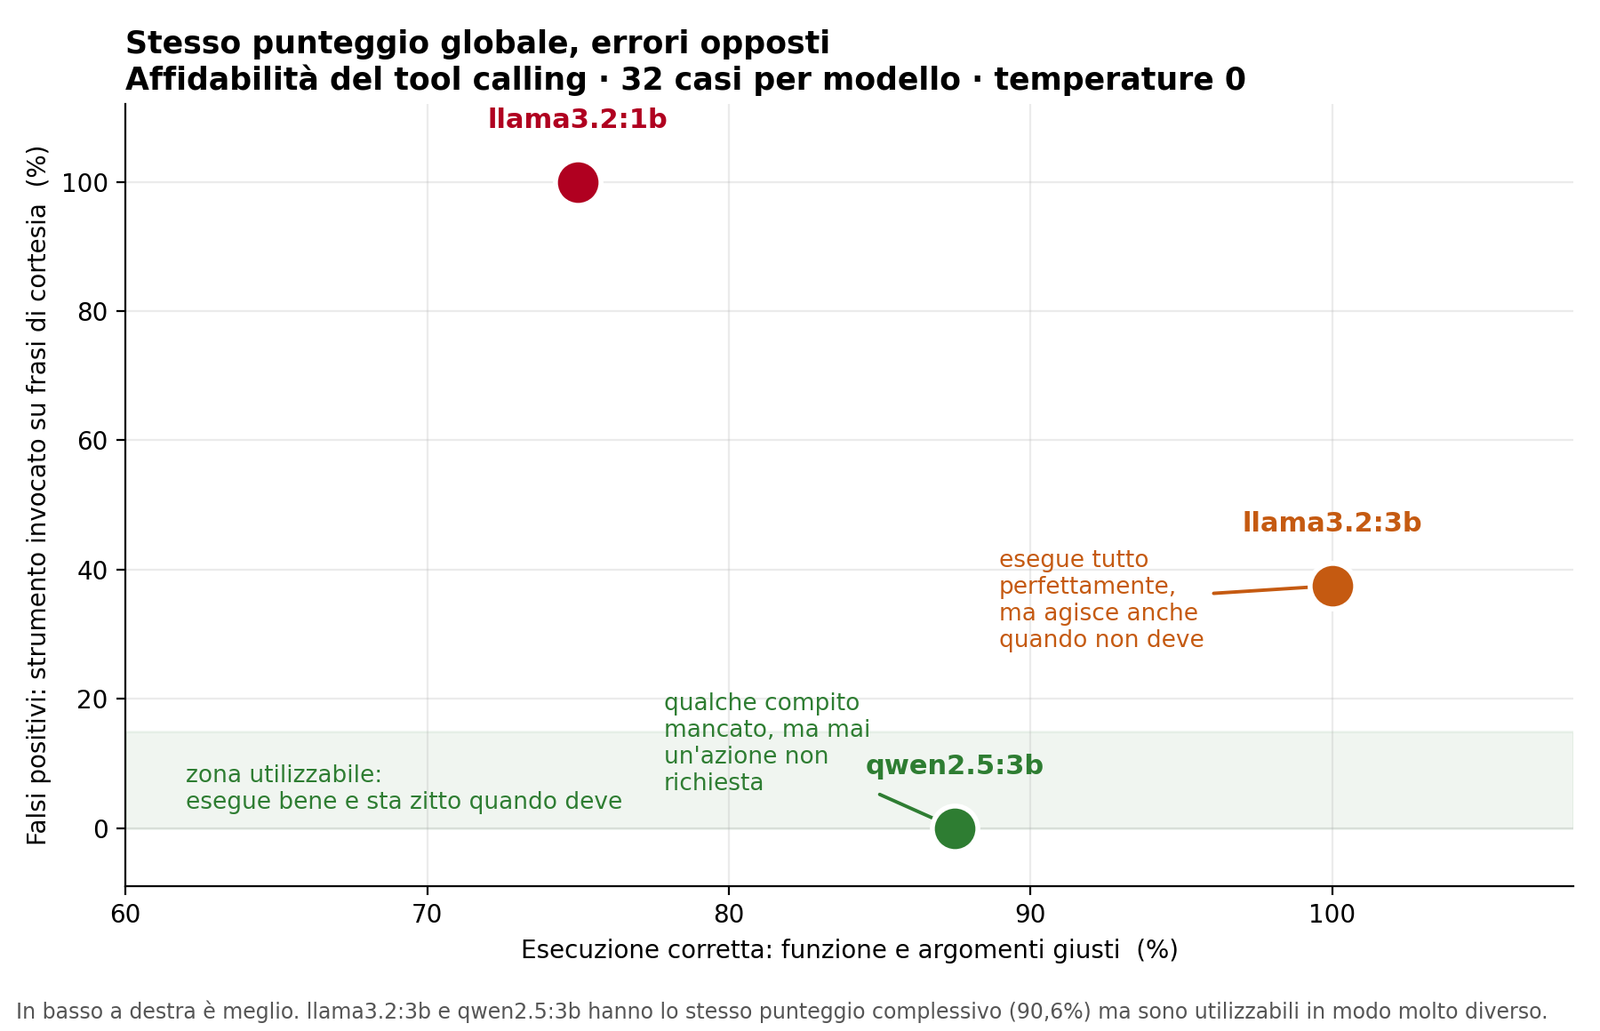
Guarda le ultime due righe. Stesso identico punteggio complessivo, 90,6%. E comportamenti opposti.
llama3.2:3b esegue perfettamente ogni compito reale: funzione e argomenti corretti al cento per cento, in italiano come in inglese, senza un errore. Ma su “ciao come va” invoca lo strumento per inviare un messaggio.
qwen2.5:3b non invoca niente su nessuna frase di cortesia. In cambio sbaglia qualche esecuzione: una volta ha scritto stanza='cucine', inventando un valore che nell’enum non esiste.
Perché vince qwen, a parità di punteggio
Primo motivo: gli errori non hanno lo stesso peso. Un falso positivo esegue un’azione — manda un messaggio a qualcuno, accende una luce in casa. Un mancato riconoscimento costa il fastidio di ripetere il comando. Non sono equivalenti.
Secondo motivo, ed è quello tecnico che conta di più: gli errori di qwen sono intercettabili dallo schema. Il valore cucine non è tra quelli ammessi dall’enum, quindi il framework lo rifiuta prima di eseguire qualsiasi cosa.
I falsi positivi di llama no. La chiamata è formalmente perfetta: nome giusto, parametri validi, sintassi corretta. Semplicemente non andava fatta. Nessuna validazione al mondo te ne salva.
Una nota statistica doverosa: con 32 campioni per modello, la differenza fra 90,6% e 90,6% non significa nulla — sono lo stesso numero. Quello che è robusto, e che decide, è il profilo degli errori: 8 contro 3 contro 0.
Un’ipotesi smentita: l’italiano non degrada
Mi aspettavo un calo di prestazioni fuori dall’inglese, che è il difetto tipico dei modelli piccoli. Non c’è: llama3.2:3b fa il cento per cento in entrambe le lingue, e qwen se la cava bene in tutte e due.
Attenzione a non leggere troppo nei numeri: con sei compiti reali per lingua e due ripetizioni, la differenza fra il 91,7% e l’83,3% di qwen è un solo caso. Non è significativa. Quello che si può dire con onestà è che l’italiano non peggiora le cose, e già questo va contro l’aspettativa.
Il consiglio pratico che ne ricavo: tieni schemi e istruzioni nella lingua in cui parli. Non per una differenza di punteggio, ma per coerenza: se il prompt di sistema e i nomi degli strumenti sono in italiano, le richieste in italiano sono in linea con tutto il resto del contesto. Il consiglio diffuso di scrivere sempre gli schemi in inglese, qui, non regge.
Quanto si aspetta, e per cosa
Misurando dopo il riscaldamento e scomponendo il tempo di una singola chiamata a strumento, con contesto da 4096 token:
| Layer su GPU | Totale | Caricamento | Lettura prompt | Generazione |
|---|---|---|---|---|
| 12 | 12,6 s | 0,4 | 0,2 | 11,8 |
| 20 | 10,4 s | 0,4 | 0,1 | 9,8 |
| 24 | 9,4 s | 0,4 | 0,1 | 8,8 |
| 28 | 7,9 s | 0,4 | 0,1 | 7,3 |
| 30 | 7,25 s | 0,4 | 0,1 | 6,7 |
| 32 | errore di memoria | — | — | — |
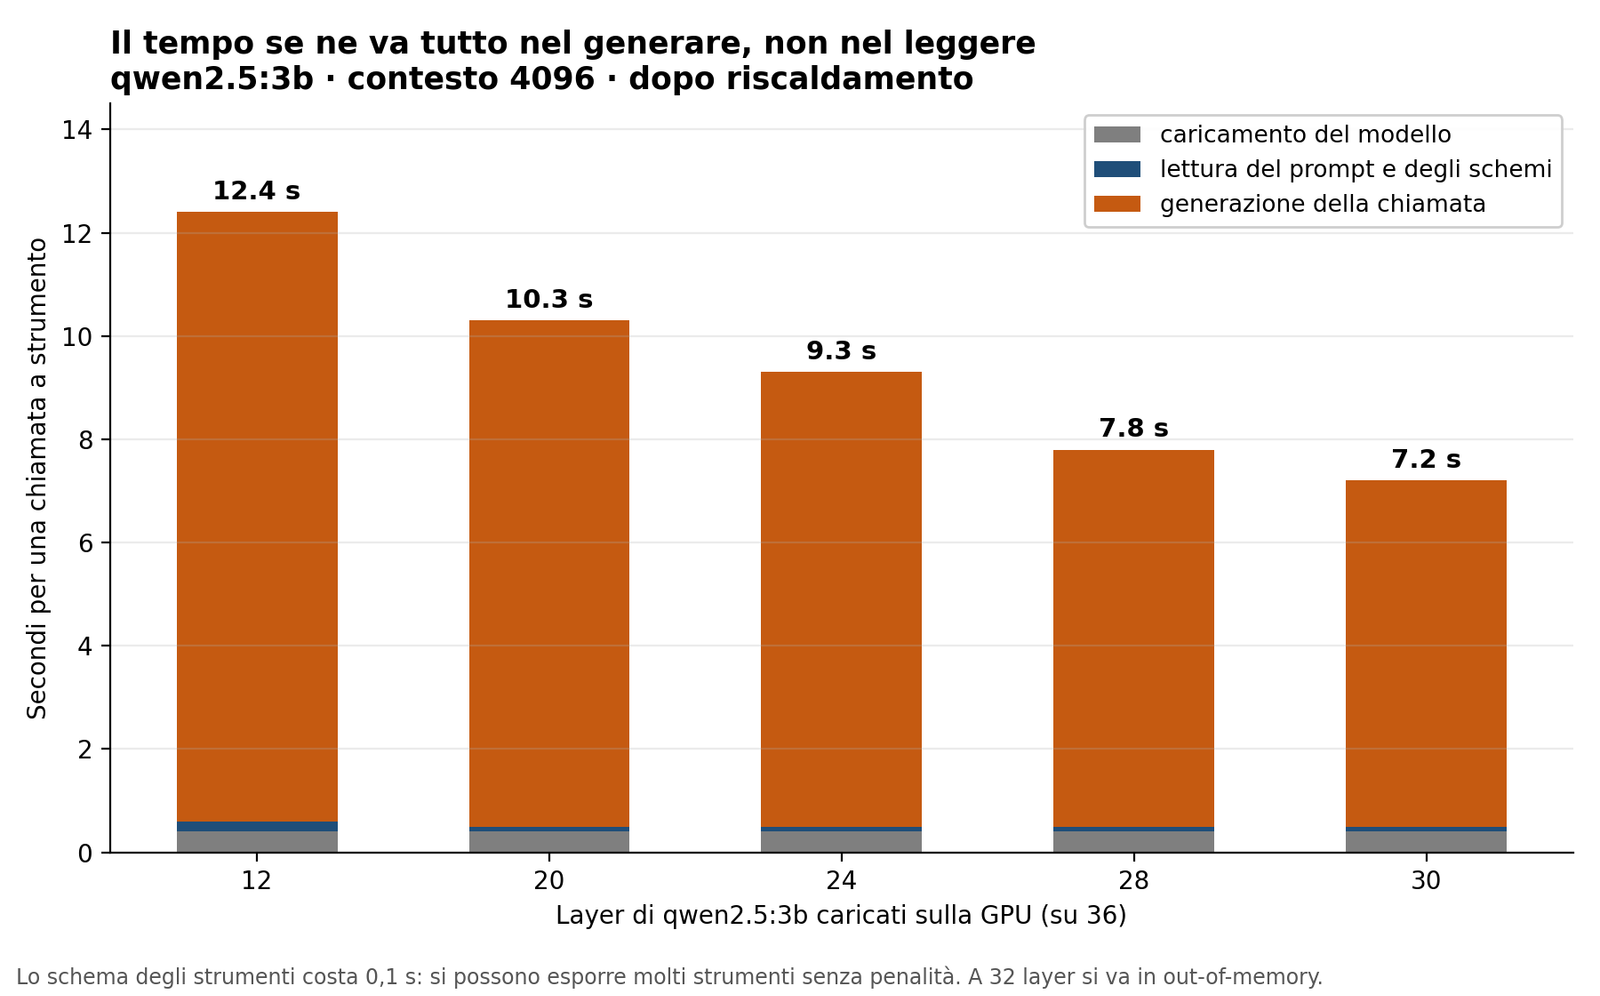
Due cose saltano all’occhio.
Lo schema degli strumenti costa 0,1 secondi. Sono circa duemila token al secondo in lettura. Significa che puoi esporre dieci o quindici strumenti con descrizioni decenti e pagare comunque meno di un secondo. Il vincolo che tutti danno per scontato — “tieni pochi strumenti e descrizioni corte” — semplicemente non esiste.
Tutto il tempo se ne va nel generare la chiamata, non nel leggere il contesto. È lì che devi intervenire se vuoi andare più veloce.
Sul numero di layer: il massimo utile è 30 su 37, con errore di memoria netto a 32. Ma a 30 si usa il 94% della VRAM su una scheda che è anche l’uscita video, e il guadagno rispetto a 28 è dell’8%. Non vale la pena stare al limite: io mi fermo a 29. Il metodo per trovare quel numero senza tirare a indovinare — e perché lasciarlo decidere a Ollama costa caro — l’ho scritto qui.
La configurazione che userei
modello:     qwen2.5:3b
num_gpu:     29
num_ctx:     4096
num_thread:  4
temperature: 0
La temperatura a 0 rende le chiamate deterministiche: stessa richiesta, stessa azione, sempre. Per un agente che tocca cose in casa è esattamente quello che vuoi.
Un dettaglio che su una macchina come la mia conta parecchio: il modello occupa 1,9 GB di VRAM e non tocca la RAM di sistema. Come ho raccontato nell’articolo sulla RAM, con sedici container attivi la memoria è la risorsa scarsa — e questa è memoria che non usa nessun altro.
Il verdetto: cosa funziona e cosa no
Funziona per azioni singole e ben definite. Accendere luci, leggere sensori, archiviare qualcosa, classificare e instradare notifiche. Circa sette secondi per azione, zero falsi positivi, esecuzione corretta sopra il 90%, e gli errori che restano li blocca la validazione dello schema.
Non funziona per conversazione generalista, per catene di più strumenti in sequenza, o per qualunque cosa richieda di tenere insieme molti passaggi. Con 2 GB di VRAM il contesto utile resta 4096 token, e lì dentro ci finiscono già istruzioni, schemi e memoria.
Il modo giusto di pensarlo non è “un assistente locale al posto di quelli cloud”. È un esecutore locale affidabile per compiti circoscritti, che gira su una macchina che stava per essere pensionata e che non manda niente fuori casa.
Il primo compito circoscritto che gli ho affidato sul serio è stato far riassumere ogni notte i log dell’homelab: il verdetto qui sopra ha retto, ma quella prova ha mostrato anche cosa un riassunto automatico non riesce a vedere.
Cosa non ho verificato
- Le catene di più strumenti. Ho testato solo chiamate singole. Un agente reale concatena — leggi il sensore, decidi, agisci — e l’affidabilità composta cala col prodotto: al 90% per chiamata, tre passaggi in fila danno il 73%.
- Il contesto lungo e le conversazioni a più turni. Tutti i casi partono da contesto vuoto.
- La tenuta nel tempo, con il modello residente per giorni.
- Modelli sotto i 3B diversi da llama. Un qwen da 1,5 miliardi di parametri starebbe interamente in VRAM lasciando molto spazio al contesto, ma sotto quella soglia il tool calling tende a crollare.
Domande frequenti
Serve una GPU per un assistente AI locale?
Aiuta molto, ma non per il motivo che si pensa. Il vantaggio principale non è la velocità — sette secondi per azione andrebbero bene anche di più — ma il fatto che il modello occupa VRAM invece di RAM di sistema, lasciando libera la memoria per gli altri servizi.
Quale modello locale è migliore per il tool calling?
Nei miei test qwen2.5:3b, non perché sbagli meno in assoluto ma perché sbaglia meglio: non invoca mai strumenti a sproposito, e gli errori che fa vengono fermati dalla validazione dello schema. Su un assistente che agisce, il tipo di errore conta più della percentuale.
Un assistente locale può sostituire quelli cloud?
No, e non è il punto. Per conversare, ragionare o concatenare più passaggi i modelli cloud sono su un altro pianeta. Il senso di un assistente locale è fare poche cose precise senza che i tuoi dati escano di casa.
Conclusione
La risposta alla domanda iniziale è sì, con un ambito preciso. E la cosa che porto a casa da questo test non è un numero, ma un criterio: quando valuti un modello per un agente, guarda come sbaglia prima di guardare quanto sbaglia.
Due modelli con lo stesso identico punteggio si sono rivelati uno utilizzabile e l’altro no. Nessun benchmark generico te l’avrebbe detto.
Nota: tutte le misure sono state raccolte sul mio homeserver con i sedici container di servizio attivi. Trentadue misure per modello, temperatura 0, mediana come valore di sintesi.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.