Mentre misuravo quanto conta il processore per un’IA locale ho scoperto una cosa imbarazzante: dentro il case del mio server c’è una GeForce GTX 750 Ti, ferma da anni perché non ho mai installato i driver.
Una scheda del 2014, con 2 GB di memoria e una banda di 86 GB/s — contro i 7,63 GB/s che riesco a spremere dalla RAM di sistema. Stavo valutando se spendere 350 euro per passare da 12,8 a 34,1 GB/s teorici, e intanto avevo quella lì che prendeva polvere.
Ho installato i driver e ho misurato. La risposta alla domanda su quanta VRAM serve per un LLM non è una scala di grigi: è una scogliera.
Una scheda del 2014 salvata da un runtime di compatibilità
Primo ostacolo, prima ancora di misurare qualcosa. I driver richiesti sono i nvidia-driver-580, l’ultimo ramo che supporta ancora l’architettura Maxwell. Ma nei log di Ollama compare questo:
skipping CUDA device — compute capability not in compiled architectures
  cc=500  archs=[750 800 860 ...]
Tradotto: CUDA 13 rifiuta la scheda. La sua compute capability è 5.0 e il minimo compilato è 7.5, cioè Turing. Ollama ripiega automaticamente su cuda_v12, che Maxwell la supporta ancora, e la GPU entra in servizio.
È una distanza di una generazione dall’essere tagliata fuori del tutto. Vale la pena saperlo se stai pensando di recuperare una scheda vecchia: funziona, ma grazie a un runtime di compatibilità che prima o poi sparirà.
VRAM realmente utilizzabile: 1,9 GiB sui 2 nominali.
La scogliera: o il modello entra, o la GPU non serve
Ho ripetuto con la GPU attiva le stesse misure che avevo fatto su CPU, sugli stessi tre modelli:
| Modello | CPU | GPU | Guadagno | Layer su GPU |
|---|---|---|---|---|
| llama3.2:1b (1,3 GB) | 5,49 | 31,40 | 5,7× | 17 su 17 |
| llama3.2:3b (2,0 GB) | 3,47 | 4,41 | 1,27× | 7 su 29 |
| mistral:7b (4,4 GB) | 1,68 | 1,85 | 1,10× | 5 su 33 |
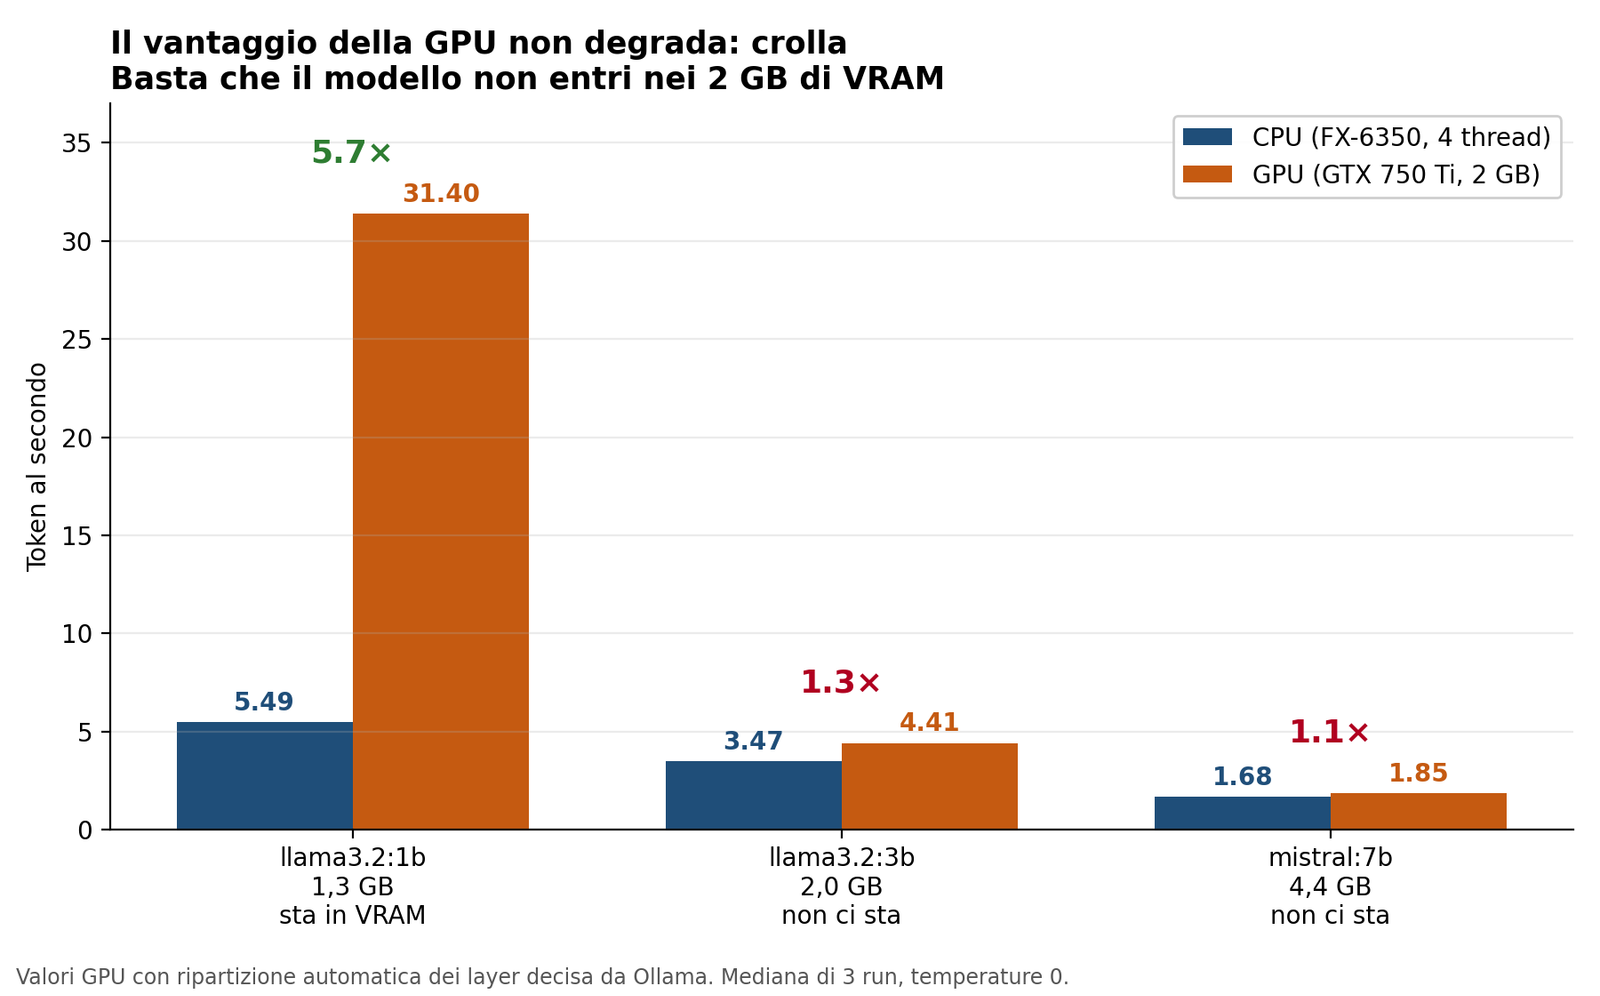
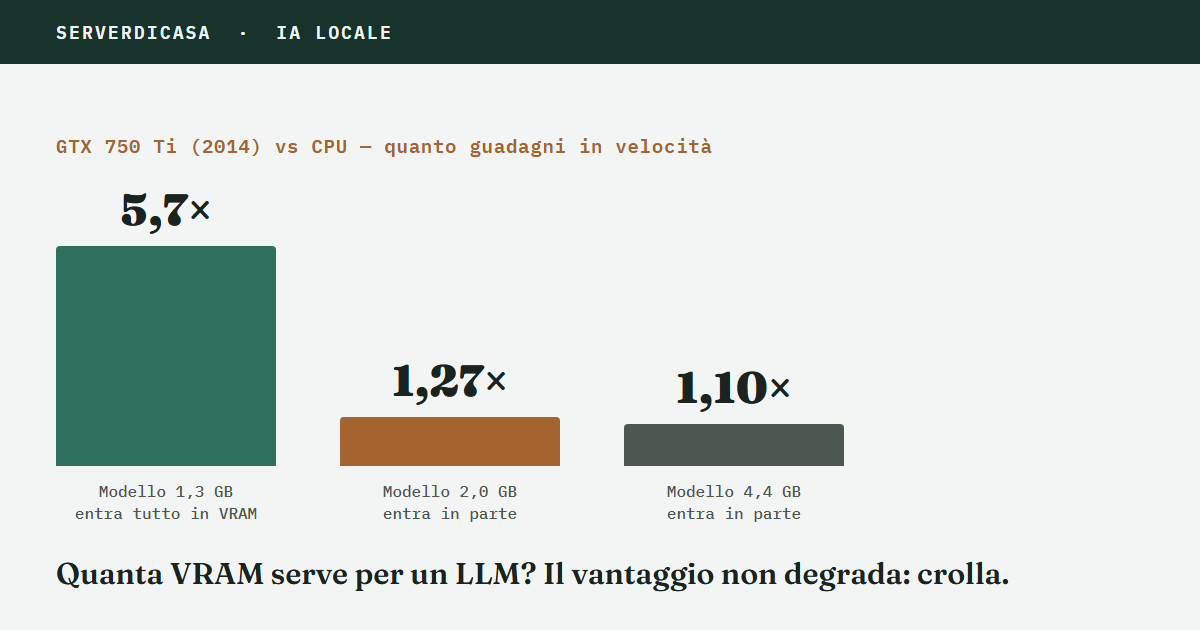
Il vantaggio non degrada: crolla. Il modello da 1,3 GB entra interamente nella VRAM e va 5,7 volte più veloce. Quello da 2,0 GB non ci sta, e il guadagno si sgonfia a 1,27×. Sul 7B la GPU vale il dieci per cento, cioè rumore.
Il motivo è semplice: i layer che non entrano restano in RAM di sistema, e vanno comunque letti a 7,63 GB/s. Sono loro a dettare il tempo, non quelli sulla scheda.
Non è quindi una questione di “quanta VRAM hai”: è binaria. O il modello ci sta dentro, o tanto vale non averla.
Perché 5,7× e non 11,3×: il collo di bottiglia si inverte
Facendo il rapporto fra le bande — 86,4 GB/s della scheda contro i 7,63 della RAM — ci si aspetterebbe un guadagno di 11,3 volte. Ne ho misurate 5,7. La metà.
Guardando cosa succede durante l’inferenza, il motivo è chiaro:
| Banda usata | Utilizzo delle unità di calcolo | |
|---|---|---|
| Su CPU | 91-97% della banda RAM | — |
| Su GPU | 40,8 di 86,4 GB/s = 47% | 92% |
Sulla CPU il limite era la memoria: l’inferenza consumava tutta la banda disponibile. Sulla GPU il limite diventa il calcolo: metà della banda resta inutilizzata mentre i core sono saturi. La 750 Ti ha 86 GB/s di banda e appena 1,3 TFLOPS per sfruttarli.
Questo ha una conseguenza importante per chi ha letto l’articolo precedente: la formula token/s ≈ banda ÷ dimensione smette di valere. Descrive solo il regime in cui il collo di bottiglia è la memoria. Su una GPU vecchia si è in un regime diverso, ed è un’altra fisica.
Per onestà: prima di misurare avevo previsto fra 35 e 50 token al secondo sul modello da 1B. Ne ho misurati 31,4. La previsione era troppo alta, perché non avevo considerato il limite di calcolo.
Ollama sbaglia la ripartizione, e ti costa il 72%
Qui arriva il risultato più utile in pratica.
Su questo punto sono poi tornato con un giro di misure più largo, su cinque modelli invece che uno: l’auto-fit di Ollama spreca la GPU, e quanto ti costa dipende da quanto è grande il modello.
Con il modello da 3B, Ollama decide da solo quanti layer mettere sulla scheda. Con 1952 MiB liberi ne usa 1119 e carica 7 layer su 29, lasciando oltre 800 MiB inutilizzati. Forzando il parametro num_gpu a mano:
| Layer su GPU | Token al secondo | VRAM usata |
|---|---|---|
| 7 (scelta automatica) | 4,41 | 1119 MiB |
| 10 | 4,74 | 1216 MiB |
| 14 | 5,37 | 1471 MiB |
| 18 | 6,21 | 1726 MiB |
| 22 | 7,60 | 1988 MiB |
| 26 | errore di memoria | — |
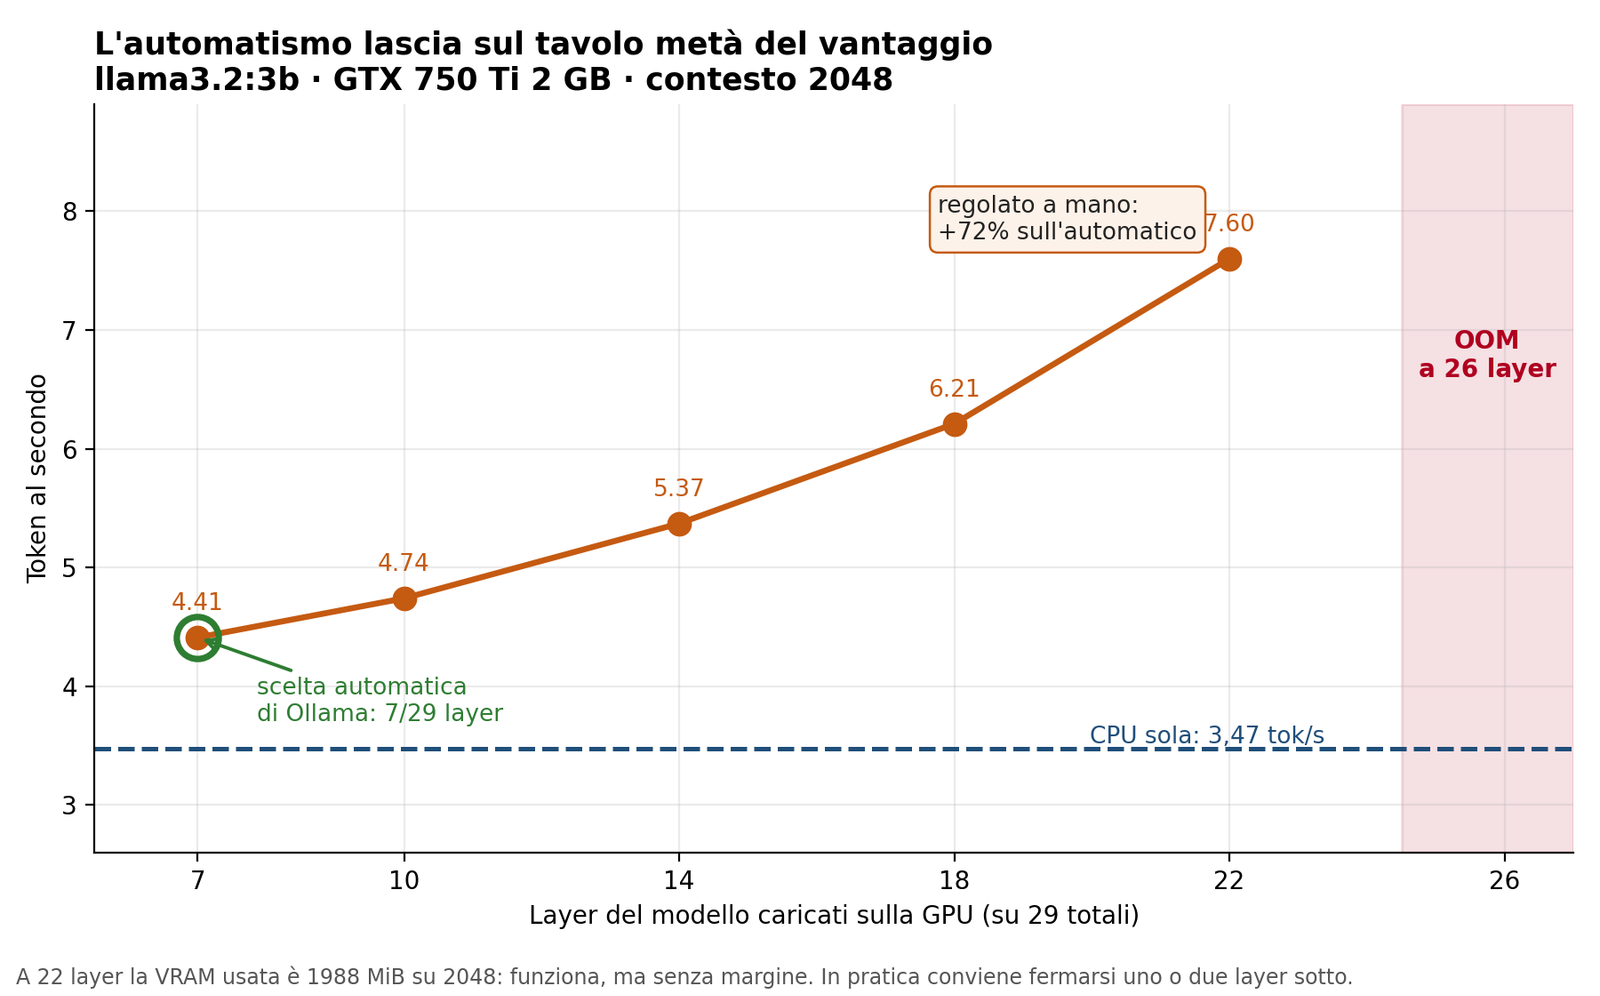
Da 4,41 a 7,60 token al secondo: +72% rispetto all’automatismo, e 2,2 volte la CPU. Il guadagno è quasi perfettamente lineare, circa 6 millisecondi per token guadagnati a ogni layer spostato.
Una cautela però va detta. A 22 layer si usano 1988 MiB su 2048: funziona con questo prompt, ma un contesto più lungo manda tutto in errore di memoria a metà generazione. Conviene fermarsi uno o due layer sotto il limite che hai trovato, e rinunciare a un paio di punti percentuali in cambio di un margine.
La leva gratuita: abbassare il contesto
C’è un modo per guadagnare VRAM senza toccare niente. Portando num_ctx da 4096 a 2048 token, la cache del contesto scende da 448 a 224 MiB, e in quello spazio ci stanno due layer in più.
Risultato: da 4,17 a 4,41 token al secondo, +5,8% a costo zero. Se non ti servono conversazioni lunghe, è il primo parametro da guardare.
Una previsione centrata e una sbagliata
Come nell’articolo precedente, avevo dichiarato le previsioni prima di misurare. Una era buona, l’altra no.
- Sbagliata: 35-50 token al secondo sul modello 1B. Misurati 31,4. Avevo ragionato solo sulla banda, ignorando che una scheda del 2014 non ha abbastanza potenza di calcolo per sfruttarla.
- Centrata: circa 8,5 token al secondo a 24 layer, con errore di memoria fra 26 e 28. Misurati 7,60 a 22 layer, con errore esattamente a 26.
Le scrivo entrambe perché un articolo che riporta solo le previsioni azzeccate è un articolo di cui non ti puoi fidare.
Domande frequenti
Quanta VRAM serve per far girare un LLM?
Almeno quanto pesa il modello, più lo spazio per il contesto. Ed è una soglia netta, non graduale: se il modello ci sta il guadagno rispetto alla CPU è di diverse volte, se non ci sta scende quasi a zero. Con 2 GB di VRAM si sta comodi solo sotto il giga e mezzo, che significa modelli da 1B quantizzati.
Conviene recuperare una GPU vecchia per l’IA locale?
Se ce l’hai già in casa, sì: nel mio caso ha più che raddoppiato la velocità sul modello da 3B, a costo zero. Comprarla oggi no, per due motivi: i 2 GB limitano troppo la scelta dei modelli, e il supporto CUDA per queste architetture è alla fine della sua vita.
Come faccio a sapere quanti layer sta caricando Ollama?
Compare nei log all’avvio del modello. Se vedi che ne carica pochi rispetto al totale e la VRAM libera è ancora parecchia, prova ad alzare num_gpu gradualmente finché non ottieni l’errore di memoria, poi torna indietro di uno o due.
Conclusione
Cinque cose che porto a casa da questo test:
- Se il modello entra in VRAM la GPU cambia tutto, se non entra quasi nulla. È binario.
- Il collo di bottiglia si sposta: memoria su CPU, calcolo su una GPU vecchia. La formula del primo articolo vale solo nel primo caso.
- Non fidarti della ripartizione automatica: alzare i layer a mano vale +72%.
- Abbassare il contesto libera VRAM ed è gratis.
- Una scheda del 2014 è ancora utile, ma solo per modelli piccoli e solo grazie a un runtime di compatibilità.
Il punto che mi resta più impresso è un altro, però. Stavo per spendere 350 euro per un processore, e la leva più efficace era un parametro di configurazione su una scheda che avevo già. Dopo la RAM e dopo il processore, la conclusione della serie arriva lunedì.
C’è anche un seguito in watt: quando il modello passa dalla GPU alla CPU non cambia solo la velocità, cambia quanto assorbe la macchina — l’ho misurato alla presa.
Nota: tutte le misure sono state raccolte sul mio homeserver con i sedici container di servizio attivi, non su una macchina dedicata. Mediana di tre esecuzioni, temperature 0.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.