Questo articolo contiene link di affiliazione. ServerDiCasa partecipa al Programma Affiliazione Amazon EU: se acquisti passando dai link presenti in questa pagina, il sito riceve una commissione senza costi aggiuntivi per te. Questo non influisce sulle valutazioni, che restano basate sui test descritti.
Stavo per spendere 350 euro. Nell’articolo su quando conviene un PC ricondizionato per l’homelab avevo messo gli occhi su un Dell con i7 e 32GB di RAM, con un’idea precisa in testa: il mio AMD FX-6350 è del 2013, se voglio far girare un modello linguistico in locale mi serve un processore più recente.
Prima di comprare ho deciso di misurare quanto conta davvero il processore per IA locale. E la misura ha detto una cosa che non mi aspettavo: non c’entra praticamente nulla.
Quello che segue sono i numeri raccolti sul mio server in una giornata di test, compresi due errori di misura in cui sono cascato e una previsione che ho sbagliato.
Il banco di prova: un server vero, con sedici container accesi
Le misure che si trovano in giro sono quasi sempre fatte su macchine pulite. La mia no: tutti i test sono stati eseguiti sull’homeserver mentre faceva il suo lavoro, con i sedici container di servizio attivi — Jellyfin, Home Assistant, Pi-hole, la suite *arr, qBittorrent, Duplicati per i backup.
È una scelta voluta: se leggi questo articolo per capire cosa succede sul tuo homelab, i numeri da banco non ti servono a niente.
La macchina è quella che ho descritto nell’articolo su come far convivere VPN, media server e domotica sulla stessa macchina:
- CPU: AMD FX-6350 Piledriver, 3 moduli e 6 thread
- RAM: 8 GB DDR3-1600, un solo banco, quindi single channel
- GPU: nessuna utilizzabile (ci torno alla fine, e non è una banalità)
- OS: Ubuntu Server 24.04, inferenza con Ollama
Una precisazione sul processore che conta più di quanto sembri: l’FX-6350 non ha sei core veri. Ha tre moduli, e i due core interi di ogni modulo condividono una sola unità in virgola mobile. Siccome l’inferenza è quasi tutta calcolo in virgola mobile, questo dettaglio si vedrà nei numeri.
Altra cosa: supporta AVX ma non AVX2, l’istruzione su cui le librerie moderne costruiscono i percorsi ottimizzati. Partivo quindi con lo svantaggio peggiore possibile.
Ollama dichiara da solo che sta girando su CPU
Prima di fidarsi di una misura conviene verificare che stia misurando quello che pensi. Nei log di avvio Ollama scrive esattamente su cosa sta calcolando:
inference compute id=cpu library=cpu total="7.7 GiB" available="5.5 GiB"library=cpu. La premessa di tutto l’articolo non è un’assunzione mia: è lo strumento che la dichiara.
Un avviso, se ripeti l’installazione: lo script di Ollama stampa AMD GPU ready e scarica ROCm anche in assenza di qualsiasi GPU AMD. È un messaggio fuorviante, non un rilevamento. Non farti ingannare come è successo a me per qualche minuto.
Quanto va davvero un modello 3B su questo hardware
Primo test: llama3.2:3b quantizzato a 4 bit, 2,0 GB su disco. Ho misurato via API invece che con ollama run --verbose, perché l’API restituisce i contatori grezzi ed è ripetibile: temperatura a 0, numero di token fisso, cinque ripetizioni per configurazione, mediana come valore finale.
| Thread | Token al secondo | min | max |
|---|---|---|---|
| 1 | 2,13 | 2,10 | 2,14 |
| 2 | 3,09 | 3,08 | 3,10 |
| 3 | 3,40 | 3,31 | 3,40 |
| 4 | 3,47 | 3,46 | 3,48 |
| 6 | 3,42 | 2,61 | 3,45 |
Il guadagno marginale racconta tutto: da 1 a 2 thread +45%, da 2 a 3 +10%, da 3 a 4 +2%, da 4 a 6 niente.
Su venticinque misure ne è uscita una anomala — quel 2,61 a sei thread — con sedici container che lavoravano. La riporto per correttezza invece di nasconderla.
La conclusione pratica è che il numero ottimale di thread è 3 o 4, non 6. Ma siccome fra 3 e 6 ballano due punti percentuali, chi cerca prestazioni regolando num_thread sta girando la manopola sbagliata.
Il processore è al massimo, e non è il problema
Qui arriva il dato che ha cambiato l’articolo. Mentre l’inferenza girava ho campionato frequenza e temperatura durante l’esecuzione, non prima:
- Frequenza massima sotto carico: 3914 MHz (la targa dice 3900)
- Temperatura massima: 42 °C
Nessun throttling termico, nessun calo di frequenza. Il processore stava dando tutto quello che ha, alla frequenza nominale piena, senza scaldarsi. Eppure il modello generava 3,47 token al secondo.
Se la CPU è al massimo e il risultato è quello, il limite sta da un’altra parte. Ho misurato la banda di memoria con un benchmark compilato apposta — array da 320 MB, molto oltre gli 8 MiB di cache L3, così da leggere davvero dalla RAM:
| Thread | Lettura |
|---|---|
| 1 | 5,95 GB/s |
| 2 | 7,54 GB/s |
| 3 | 7,62 GB/s |
| 4 | 7,61 GB/s |
| 6 | 7,63 GB/s |
Il tetto reale è 7,63 GB/s, cioè il 60% dei 12,8 teorici del DDR3-1600 single channel: un’efficienza del tutto normale. E soprattutto la banda satura a due thread, esattamente come la generazione dei token.
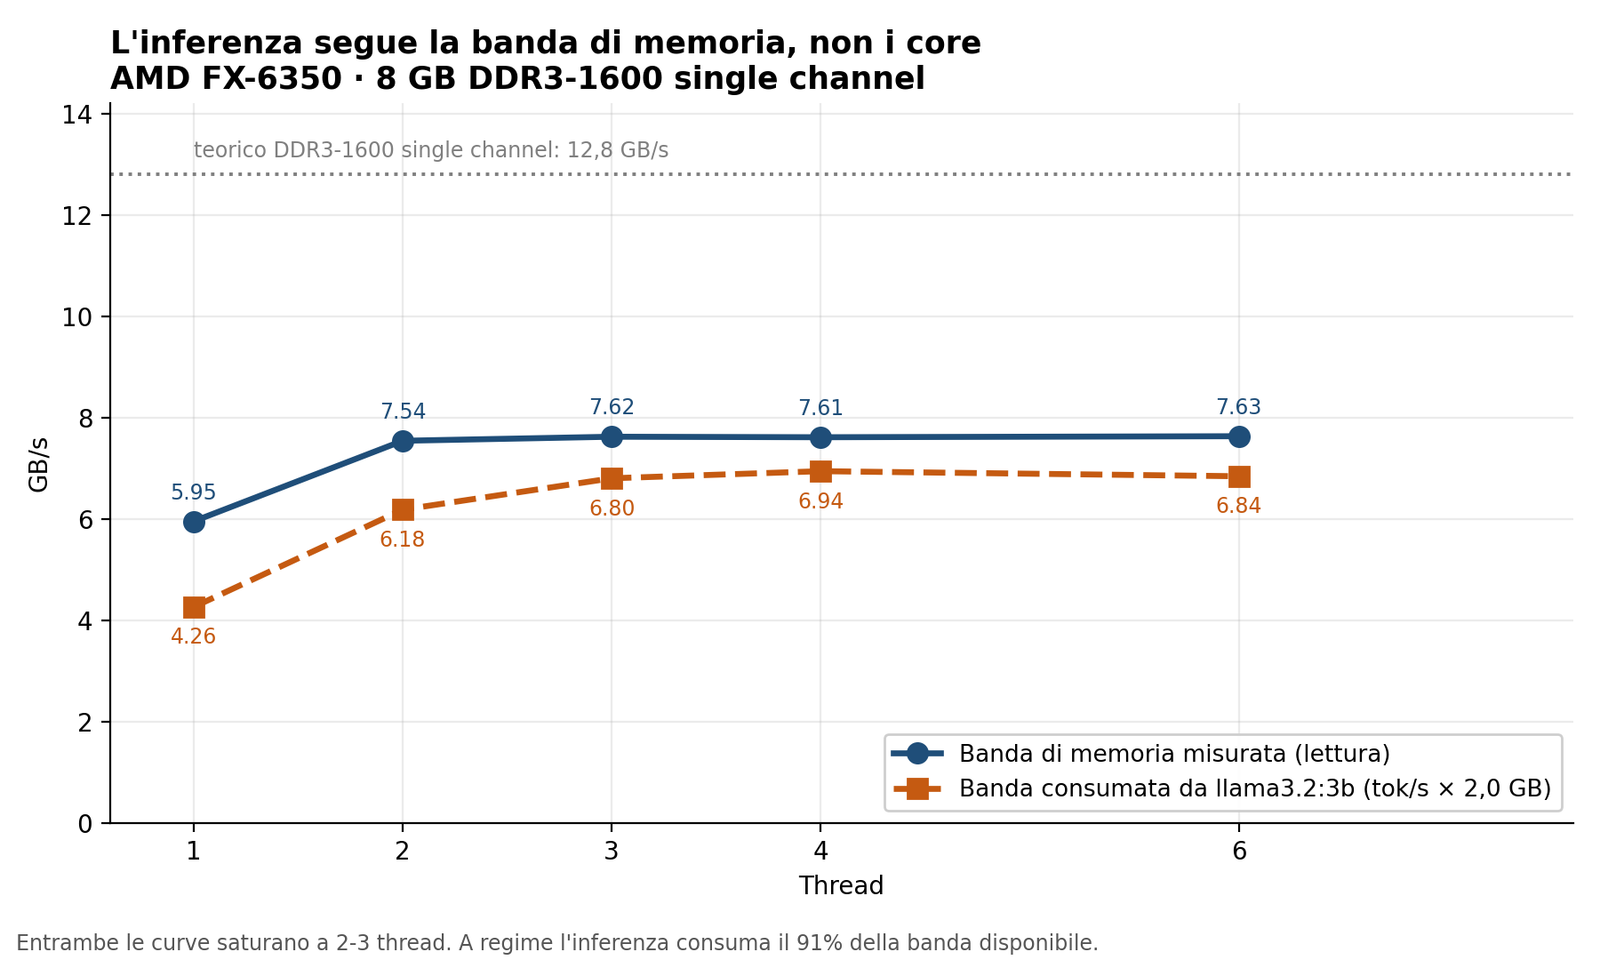
Sovrapponendo le due curve si vede che l’inferenza consuma il 91% della banda disponibile. Non è una coincidenza: le due curve sono quasi parallele perché misurano lo stesso muro.
La legge: token al secondo = 7,15 ÷ GB del modello
A questo punto l’ipotesi era chiara: se il limite è la banda, e ogni token generato richiede di rileggere l’intero set di pesi del modello, allora la velocità dovrebbe dipendere solo dalla dimensione del modello. Per verificarlo servivano altri modelli.
| Modello | Dimensione | Quantizzazione | Token/s | Banda consumata |
|---|---|---|---|---|
| llama3.2:1b | 1,3 GB | Q8 | 5,47 | 7,11 GB/s |
| llama3.2:3b | 2,0 GB | Q4 | 3,47 | 6,94 GB/s |
| mistral:7b | 4,4 GB | Q4 | 1,68 | 7,39 GB/s |
Su un intervallo di dimensioni di 3,4 volte, la banda consumata resta inchiodata intorno a 7,15 GB/s. Da cui:
token/s ≈ 7,15 ÷ (dimensione del modello in GB)| Modello | Previsto | Misurato | Errore |
|---|---|---|---|
| llama3.2:1b | 5,50 | 5,47 | 0,5% |
| llama3.2:3b | 3,57 | 3,47 | 3,0% |
| mistral:7b | 1,62 | 1,68 | 3,3% |
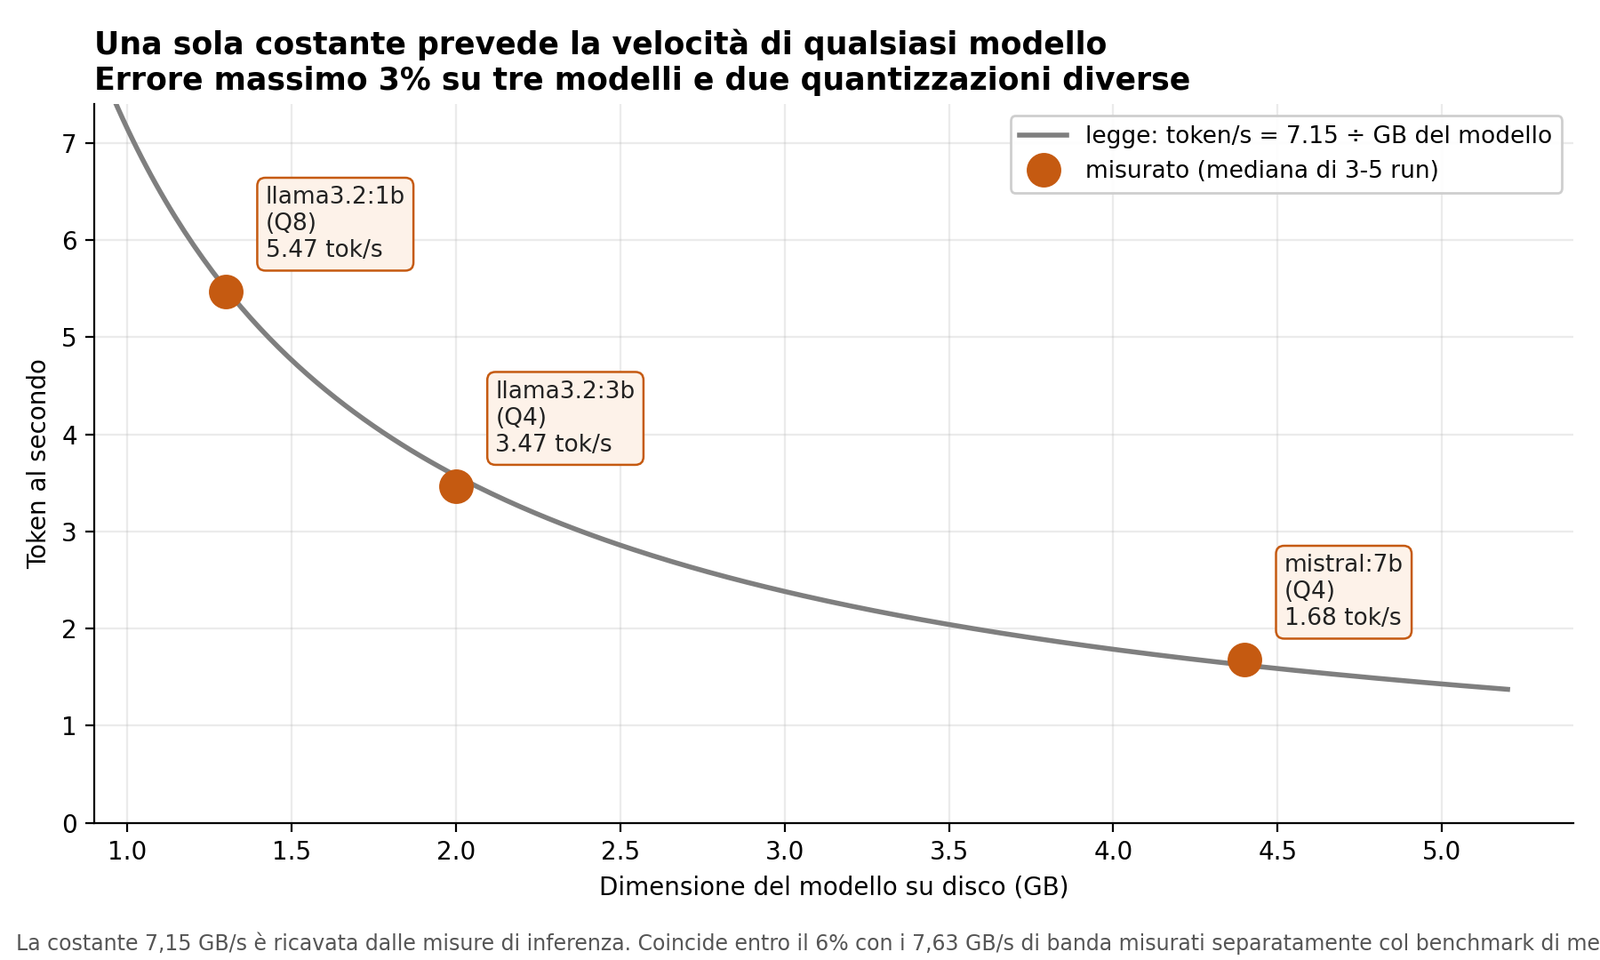
Devo essere onesto su un punto: la costante 7,15 è ricavata dalle misure di inferenza, quindi è un parametro adattato ai dati, non una previsione uscita dal nulla. Il fatto che conta è un altro — coincide entro il 6% con i 7,63 GB/s misurati separatamente dal benchmark di memoria, che con Ollama non ha nulla a che vedere. Due strumenti indipendenti arrivano allo stesso numero.
E c’è un dettaglio che rende la legge solida: i tre modelli non condividono la quantizzazione. Uno è a 8 bit, due a 4 bit. Se il collo di bottiglia fosse il calcolo, quantizzazioni diverse darebbero comportamenti diversi, perché il lavoro aritmetico cambia. Non succede: contano solo i byte da leggere. È la prova più pulita che il limite è la memoria e non il processore.
Una previsione che ho sbagliato
Prima di misurare il modello da 1B avevo previsto un’efficienza più bassa, sul 75-85%: con un modello piccolo la quota di calcolo pesa relativamente di più, quindi mi aspettavo di allontanarmi dal tetto di banda.
Misurato: 93%, l’efficienza più alta dei tre.
La previsione era sbagliata, e l’ipotesi che c’era dietro pure: l’efficienza non dipende dalla dimensione del modello. La scrivo perché un articolo che riporta solo le previsioni azzeccate è un articolo di cui non ti puoi fidare.
Prefill e decode: due colli di bottiglia diversi
Un’ultima cosa che quasi nessuno distingue. L’inferenza ha due fasi: la lettura del prompt (prefill) e la generazione della risposta (decode). Si comportano in modo opposto.
| Thread | Lettura del prompt | Generazione |
|---|---|---|
| 1 | ~82 tok/s | 2,13 tok/s |
| 2 | ~119 tok/s | 3,09 tok/s |
| 3 | ~128 tok/s | 3,40 tok/s |
| 4 | ~135 tok/s | 3,47 tok/s |
La lettura del prompt è limitata dal calcolo e continua a salire fino a 4 thread, con un +65%. La generazione è limitata dalla memoria e si appiattisce a 3.
Nello stesso modello, sulla stessa macchina, nello stesso momento: due regimi diversi. Ecco perché ha poco senso parlare di “velocità” di un LLM con un numero solo.
Come NON misurare su un server in produzione
Tre errori in cui sono cascato, e che valgono più di molti risultati.
Il benchmark che misurava la cache. sysbench memory mi dava 19 GB/s con un thread e 90 GB/s con sei, su una RAM il cui massimo teorico è 12,8. Alloca un buffer per thread e lo rilegge in ciclo: lavora dentro le cache, misura la L2 e non la RAM. Scala linearmente proprio perché ogni thread ha la sua cache privata. Se avessi pubblicato quel numero avrei scritto una sciocchezza con tre cifre decimali.
Le run consecutive. La prima sequenza mostrava un crollo a 4 e 6 thread: 3,00 e 0,77 token al secondo. Sembrava la conferma perfetta della teoria sulle FPU condivise. Ripetendo con venti secondi di pausa fra una run e l’altra, gli stessi test danno 3,47 e 3,42, stabili. Non era il processore: era contesa transitoria sull’I/O, subito dopo aver scritto 2 GB di modello su disco, con la page cache scesa da 6053 a 3601 MB e sedici container a litigarsi il disco.
Era la conclusione più interessante dell’articolo, ed era falsa.
La frequenza letta nel momento sbagliato. Leggere /proc/cpuinfo prima di lanciare la chiamata misura la CPU a riposo: 1401 MHz. Campionando in background durante l’inferenza: 3914 MHz. Sono due articoli diversi a seconda di quale numero pubblichi.
Allora conviene l’i7 ricondizionato?
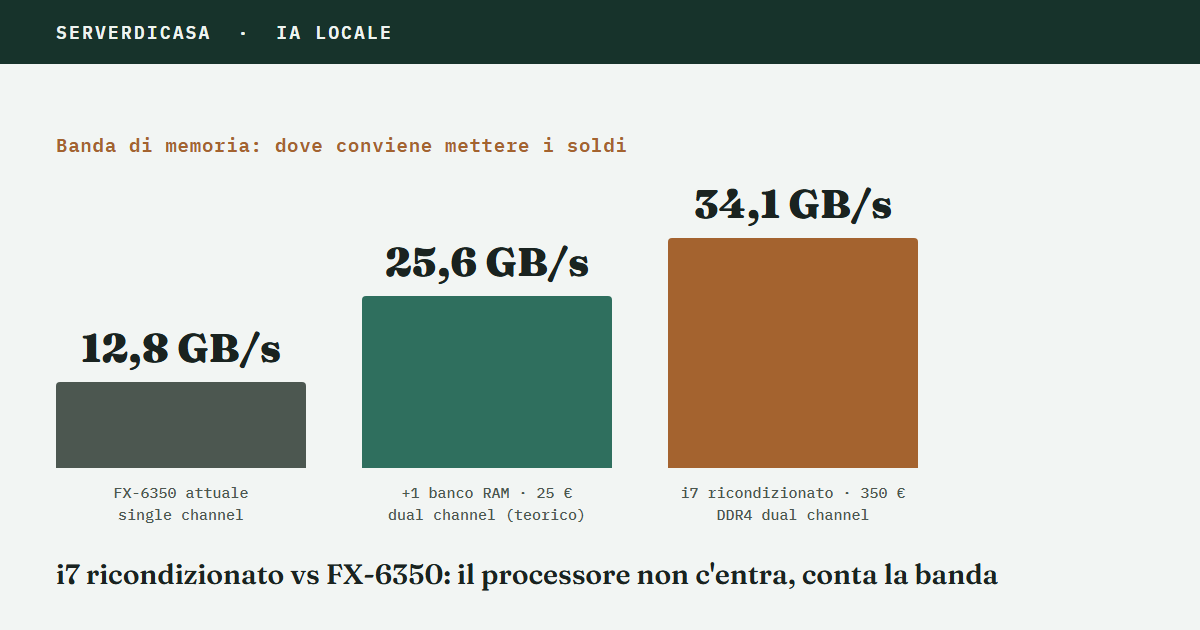
Torniamo ai 350 euro. Il Dell con i7-6700 monta DDR4-2133 in dual channel, cioè 34,1 GB/s teorici contro i 12,8 della mia configurazione attuale: +166%.
Applicando la legge e assumendo la stessa efficienza del 60% che ho misurato sulla mia RAM, il modello 3B dovrebbe arrivare intorno ai 9 token al secondo, contro i 3,47 di oggi. Sarebbe un salto reale, che porterebbe un 3B dentro la soglia della lettura scorrevole. Metto le mani avanti: è una stima, non una misura. Quel Dell non ce l’ho, e l’efficienza reale della sua memoria potrebbe essere diversa dalla mia. Prendila per quello che è, un ordine di grandezza ricavato dalla legge.
Ma il confronto onesto è un altro. Il mio server ha un solo banco di RAM su due slot. Un secondo banco DDR3-1600 da 8 GB identico al mio porterebbe la banda a 25,6 GB/s teorici — il doppio, per circa 25 euro — raddoppiando per giunta la RAM totale e togliendo il problema che ho avuto col modello da 7B.
Venticinque euro contro trecentocinquanta, per prendere gran parte dello stesso guadagno.
Con una riserva che devo dichiarare: su questa macchina lo slot libero è guasto. Non ho potuto misurare il dual channel, quindi il 25,6 GB/s resta un valore teorico e non una misura. Se il tuo slot funziona, prima di guardare i processori guarda quanti banchi hai montato — è il controllo più economico che esista.
Quanto al PC ricondizionato che stavo valutando, la decisione la prendo in un articolo dedicato: questi numeri hanno cambiato le carte in tavola.
Cosa ci fai davvero con questa velocità
| Modello | Token/s | ≈ parole/s | Uso realistico |
|---|---|---|---|
| 1B | 5,47 | ~3,9 | al limite della lettura scorrevole |
| 3B | 3,47 | ~2,5 | elaborazioni in background |
| 7B | 1,68 | ~1,2 | un paragrafo al minuto, non interattivo |
Detto senza giri di parole: su questo hardware un’IA locale conversazionale non è realistica. Per un compito che gira da solo mentre fai altro — riassumere, classificare, estrarre dati da file — un 3B è perfettamente utilizzabile.
Domande frequenti
Quanti token al secondo servono perché sia utilizzabile?
Per seguire il testo mentre viene scritto servono circa 5-7 token al secondo, che è la velocità di lettura scorrevole. Sotto i 2 si guarda la risposta comparire una parola alla volta e l’uso interattivo diventa frustrante. Per elaborazioni in background, invece, anche 1,5 token al secondo vanno benissimo: nessuno sta a guardare.
Meglio più core o più banda di memoria?
Per la generazione dei token, banda, senza discussione. I miei dati mostrano che oltre 2-3 thread la velocità non sale più, mentre dipende in modo quasi perfetto dalla dimensione del modello, cioè dai byte da leggere a ogni token. I core aiutano nella lettura del prompt, che è l’altra metà del lavoro, ma se il tuo obiettivo è vedere la risposta arrivare più in fretta la leva è la memoria.
Un modello 7B gira davvero su 8 GB di RAM?
Gira, con 1,68 token al secondo perfettamente stabili. Ma non è gratis: per farcelo stare il sistema ha sfrattato circa un giga di memoria agli altri servizi, che restano attivi con parte delle loro pagine finite su disco. È un tema che merita un articolo a parte, ed è quello che ho scritto sulla RAM necessaria per un’IA locale.
Conclusione
Ero convinto che il mio problema fosse un processore del 2013. I numeri dicono che il processore girava alla frequenza piena, a 42 gradi, senza mai andare in affanno — e che la velocità di generazione si prevede con una divisione, conoscendo solo la banda di memoria e la dimensione del modello.
C’è un seguito a questa storia, ed è sempre un parametro di configurazione invece di un pezzo nuovo: quanti layer mettere sulla GPU, e perché il valore che sceglie Ollama da solo è quasi sempre quello sbagliato. E ce n’è una terza, della stessa famiglia: quale versione del modello scaricare, perché fra Q3 e Q8 dello stesso modello, sulla stessa scheda, ci sono 2,38× di differenza.
Se stai valutando un upgrade per far girare modelli in locale, il primo controllo non costa niente: guarda quanti banchi di RAM hai montato e a che frequenza vanno. Potresti scoprire, come me, di stare usando metà della banda che hai già pagato.
E c’è un ultimo dettaglio. Mentre cercavo di capire se spendere 350 euro per passare da 12,8 a 34,1 GB/s, mi sono accorto che dentro quel case c’è una GeForce GTX 750 Ti da 86 GB/s, ferma da anni perché non ho mai installato i driver.
Ne parliamo nel prossimo articolo.
Nota: tutte le misure di questo articolo sono state raccolte il 31 luglio 2026 sul mio homeserver, con i servizi di produzione attivi. I valori relativi al dual channel sono teorici e dichiarati come tali, perché lo slot RAM libero della macchina è guasto e il confronto non era eseguibile.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.