All’inizio di questa serie avevo scoperto che il processore non era il problema. Poi, che la RAM decide cosa carichi ma non quanto vai veloce. Poi ancora, che una GTX 750 Ti dimenticata nel case dava un guadagno gratuito, a patto di forzare a mano quanti layer mandarle. Ho deciso di non comprare l’upgrade, e ho iniziato a usare quello che avevo per un servizio vero — un LLM locale che ogni notte legge e riassume i log dell’homelab.
Questa volta la domanda non era “cosa mi serve”: era diretta, quasi banale — posso ottimizzare quello che ho già? La risposta ha quattro parti. La prima è il guadagno che mi aspettavo di trovare. La seconda è una scoperta che mi obbliga a correggere qualcosa che avevo scritto nove giorni fa, e che ho già corretto nell’articolo dove l’avevo scritto. La terza è arrivata provando la leva successiva, lo stesso giorno: un modo per recuperare quello che la seconda parte aveva tolto — e superarlo. La quarta è arrivata sei giorni dopo, rifacendo lo stesso giro di prove sui modelli che nel frattempo erano usciti.
Cosa fa (male) l’auto-fit di Ollama
Quando carichi un modello, Ollama decide da solo quanti dei suoi layer mandare sulla GPU e quanti lasciare sulla CPU. Lo fa con un suo algoritmo interno — nei log di sistema compare come common_params_fit_impl — che stima quanta VRAM è disponibile e quanti layer ci stanno.
Il problema è che quella stima è conservativa, a volte troppo. L’ho misurato confrontando, per ciascun modello, la velocità con la scelta automatica di Ollama contro la velocità ottenuta forzando a mano il numero di layer con il parametro num_gpu:
| Modello | Auto-fit | Forzato | Guadagno |
|---|---|---|---|
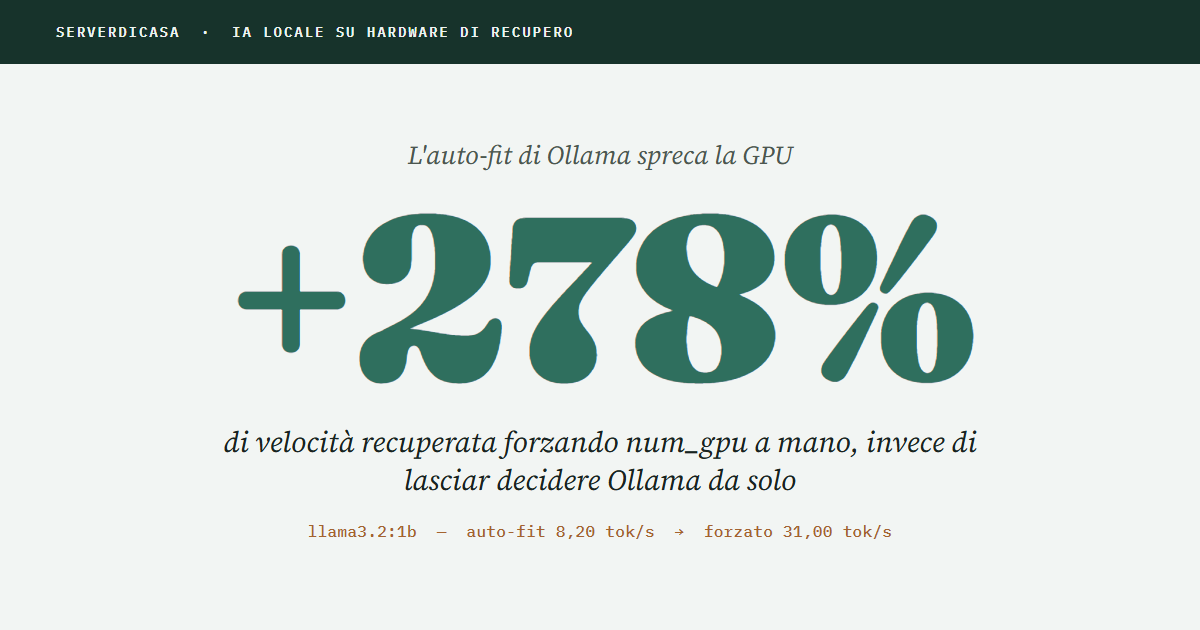
| llama3.2:1b (17 layer) | 8,20 tok/s (6/17 in VRAM) | 31,00 tok/s (17/17, tutto offloadato) | +278% |
| qwen2.5:3b (37 layer) | 4,49 tok/s (11/37 in VRAM) | 7,33 tok/s (28/37) | +63% |
| llama3.2:3b (29 layer) | 4,00 tok/s (5/29 in VRAM) | 6,00 tok/s (18/29) | +50% |
| mistral:7b (33 layer) | 1,74 tok/s | nessun valore forzato regge | — |
Su tre modelli su quattro, lasciare fare a Ollama significa buttare via dalla metà a quasi quattro volte la velocità disponibile. L’eccezione è mistral:7b, dove il modello è troppo grande perché la GPU da 2 GB faccia una differenza qualsiasi: anche il primo tentativo di forzatura (num_gpu=16) è andato in errore di memoria.
La configurazione di produzione, finalmente giustificata da un numero
Il servizio che legge i log ogni notte sull’homeserver girava, il giorno in cui ho fatto queste misure, su qwen2.5:3b con num_gpu 28. Quando l’ho scritto, quel numero veniva da un tentativo che funzionava — non da una misura specifica contro l’auto-fit.
Adesso ce l’ho: +63% rispetto a quello che Ollama avrebbe scelto da solo. Il test principale l’ho fatto a num_ctx 4096, non agli 8192 che usavo allora in produzione — così l’ho rifatto separatamente proprio alle impostazioni reali: +65% (4,47 contro 7,37 token al secondo), il guadagno regge, anzi è leggermente più alto. Senza quella riga scritta a mano nel comando di avvio, lo script che gira ogni notte alle 03:15 UTC impiegherebbe circa il 65% di tempo in più — ancora accettabile per un compito che nessuno sta a guardare, ma non più il minimo che si può ottenere sull’hardware che ho.
Nota del 26 agosto 2026, aggiunta prima che questo articolo uscisse. Quella configurazione non c’è più: nel frattempo il digest notturno è passato prima a qwen2.5:3b-instruct-q8_0 con num_gpu 18, e poi a granite4.2:3b con num_ctx 4096, num_gpu 33 e num_thread 5. I numeri qui sopra restano validi come misura — il guadagno del forzare num_gpu è quello — ma vanno letti come una fotografia del 19 agosto, non come la mia configurazione di oggi.
E il cambio ha aggiunto una cosa che questo articolo non dice, e che vale la pena sapere se state per copiare un numero da qui: num_gpu non si sceglie da solo, si sceglie insieme a num_ctx. Il contesto occupa VRAM, e la VRAM sono layer. Sullo stesso modello, a num_ctx 8192 il tetto è 30 layer; scendendo a 4096 diventa 33, e la velocità sale da 6,50 a 7,62 token al secondo. Prima di cercare il num_gpu massimo conviene quindi chiedersi quanto contesto serve davvero: nel mio caso avevo tenuto 8192 per abitudine, e misurando gli input reali ho scoperto che il più grande era di 1177 token.
Il modello che entra tutto cambia categoria
Il guadagno più grosso, +278%, non è un caso isolato: è la stessa cosa già vista nell’articolo sulla VRAM, letta da un angolo diverso. Là avevo misurato che passare da CPU pura a GPU piena su llama3.2:1b portava da 5,49 a 31,40 token al secondo — +472%, cioè il 5,7× di guadagno che avevo misurato allora. Attenzione a non confonderlo con il rapporto fra le bande di memoria, che è quasi il doppio (11,3×): in quell’articolo c’è una sezione dedicata proprio al perché il guadagno reale si ferma a metà strada.
Oggi però il confronto è un altro, e va detto perché non è lusinghiero. Quei 31,40 token al secondo Ollama li faceva da solo: 17 layer su 17, scelti dall’auto-fit. Il 19, sulla stessa macchina, la scelta automatica si ferma a un offload parziale e dà 8,20. Gli stessi 31,00 tornano solo forzando num_gpu a 17. Il salto rispetto all’offload completo resta nell’ordine delle centinaia di punti percentuali, ma il merito non è dell’auto-fit: è tutto della forzatura. Resta però netta la distinzione fra i modelli: solo quello che entra interamente in VRAM cambia categoria. I due modelli da 3b, che si fermano a metà tra CPU e GPU anche una volta forzati, guadagnano — ma restano in un regime intermedio, non nella “scogliera” descritta nell’articolo sulla VRAM: è più un pendio, ripido ma continuo.
La correzione: il tetto VRAM si è ristretto in 12 giorni
Qui arriva la parte che non mi aspettavo, e che vale la pena raccontare per intero perché cambia qualcosa che ho già pubblicato.
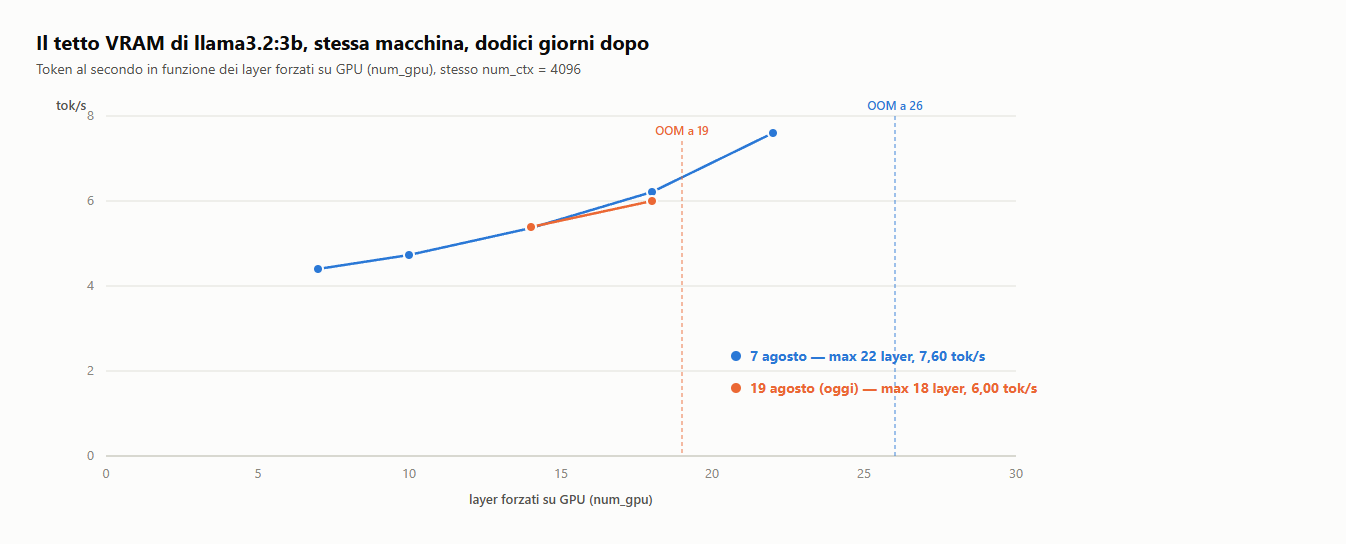
Nell’articolo del 7 agosto avevo trovato, su llama3.2:3b con num_ctx a 4096, un massimo stabile di 22 layer (7,60 token al secondo), con errore di memoria solo a 26. Da lì avevo scritto, nell’articolo di tre giorni dopo sulla decisione di non comprare il PC ricondizionato, di tenermi 20-21 layer come margine di sicurezza.
Rifacendo la stessa identica misura oggi, stesso modello, stesso contesto:
| 07/08 | 19/08 (oggi) | Delta | |
|---|---|---|---|
| Layer massimo stabile | 22 | 18 | -18% |
| Velocità a quel layer | 7,60 tok/s | 6,00 tok/s | -21% |
| Primo layer che va in errore | 26 | 19 | — |
Il margine di sicurezza che avevo consigliato — 20-21 layer — oggi va in errore di memoria. L’ho verificato con attenzione prima di scriverlo, perché è un’affermazione che corregge un mio consiglio pubblico: num_gpu=18 ha retto tre run su tre (6,03 / 5,97 / 6,01 token al secondo, sempre identici 1963 MiB usati), num_gpu=19 è andato in errore due volte su due. Non è rumore statistico. È un confine netto, solo diverso da quello di dodici giorni fa.
Una cosa che quella tabella non mostra: non si è ristretto solo il tetto, si è abbassato anche il pavimento. Il 7 agosto l’auto-fit su questo modello sceglieva 7 layer su 29 e dava 4,41 token al secondo; il 19 ne sceglie 5 e ne dà 4,00. È anche il motivo per cui qui il guadagno del forzare num_gpu risulta +50%, mentre nell’articolo del 7 agosto avevo pubblicato +72%: i due estremi si sono avvicinati.
Ho già aggiunto una nota di aggiornamento nell’articolo del 10 agosto, con la data, senza cancellare quello che avevo scritto allora: era corretto quando l’ho misurato, e la serie ha sempre pubblicato anche le previsioni sbagliate.
Cosa ho escluso, e cosa resta senza risposta
Prima di scrivere “il tetto si è ristretto” ho provato a capire perché, controllando tutto quello che mi veniva in mente:
- Il binario di Ollama è identico bit per bit a quello di allora: data di modifica 27 luglio, mai toccato da quel giorno, versione 0.32.5 su entrambe le misure.
- Il driver GPU non è cambiato: 580.173.02, nessun aggiornamento registrato, nessun riavvio del server dal 31 luglio.
- Il file del modello non è mai stato riscaricato.
- La VRAM libera a riposo è addirittura leggermente più alta oggi (1985 MiB) di quanto risultasse nell’articolo del 7/08 (1952 MiB) — quindi non è che qualcos’altro oggi occupa più spazio quando non gira niente.
Quello che ho trovato guardando i log grezzi di llama.cpp durante i tentativi falliti è che il buffer di calcolo usato per elaborare il prompt (separato dai pesi del modello e dalla cache del contesto) non ha una dimensione fissa: negli errori ho visto richieste da 158, 254 e 400 MiB a seconda del punto esatto in cui cade il taglio tra CPU e GPU. Vicino al limite fisico dei 2 GB, è questo buffer — non l’accumulo lineare dei pesi layer per layer — a decidere se il caricamento riesce.
Questo spiega il meccanismo, non la causa. Non so perché oggi quel buffer richieda più margine di dodici giorni fa sulla stessa identica configurazione software. Lo scrivo perché è la cosa onesta da fare, non perché ho una teoria da proporre spacciandola per conclusione.
E c’è un controllo che rafforza proprio questa onestà: non è un fenomeno generale del sistema. Lo stesso giorno ho verificato anche qwen2.5:3b, controllando in particolare il valore che avevo pubblicato nell’articolo sul tool calling (num_gpu: 29, scelto lì come margine prudente). Risultato: stabile tre run su tre. E il confine non si è spostato di un layer: l’errore di memoria cade a 32 oggi esattamente come nell’articolo di allora, con il 30 che continua a funzionare in entrambe le misure — 8,09 token al secondo, 1934 MiB, cioè lo stesso 94% di VRAM che avevo scritto. Il 31, che oggi regge, allora non l’avevo nemmeno provato: era il buco fra l’ultimo valore testato e il primo che falliva. Se il restringimento fosse stato un problema di sistema — VRAM sottratta da qualcos’altro, un aggiornamento silenzioso, un degrado del driver — avrebbe dovuto colpire anche questo modello, sulla stessa macchina, lo stesso pomeriggio. Non l’ha fatto. Il restringimento del tetto sembra quindi specifico a llama3.2:3b, non una deriva della macchina. Un distinguo però va fatto, perché tira nella direzione opposta: quello che si è abbassato non è il tetto di un modello solo, è la stima su tutti e due quelli che ho rimisurato — il crollo dell’auto-fit su llama3.2:1b che ho raccontato più sopra, e i due layer persi qui su llama3.2:3b. E la stima non ha niente a che vedere con la capienza della scheda: forzato a 17 su 17, il modello da 1B parte senza il minimo errore di memoria. Non si è ristretta la scheda: si è ristretta la stima.
Nota del 09/09/2026. La sezione qui sopra concludeva che il tetto si fosse ristretto senza una causa identificabile. Ricontrollando i dati grezzi, una causa c’è, e mi era sfuggita: il grafico di questa correzione dichiara lo stesso num_ctx per le due misure, ma non è così. Il titolo del grafico dell’articolo del 7 agosto dice esplicitamente “contesto 2048”, e la scomposizione della VRAM registrata quel giorno (667 MiB di pesi + 224 di KV cache + 228 di buffer) conferma 224 MiB di KV cache — che è il valore a num_ctx 2048, non 4096 come questa correzione dava per scontato. La misura del 19 agosto, invece, era davvero a num_ctx 4096. Raddoppiare il contesto costa 224 MiB di KV cache in più, che al costo per layer misurato in questo stesso sweep (circa 64 MiB) valgono 3,5 layer: 22 meno 3,5 fa 18,5, arrotondato per difetto esattamente ai 18 layer misurati — e il conto assoluto torna altrettanto bene (18 layer a 4096 dovrebbero pesare 1950-1980 MiB, contro i 1963 misurati). Non era un mistero del driver o della macchina: erano due misure a contesti diversi, confrontate come se fossero identiche.
Una leva che recupera il tetto, e lo supera
Non mi sono fermato alla correzione. Se il tetto si è ristretto senza una causa che riesco a spiegare, c’è comunque un modo per riguadagnare margine? Sì: la KV cache quantizzata.
Di default Ollama tiene la cache del contesto (le chiavi e i valori dell’attention, non i pesi del modello) in f16. Attivando due variabili d’ambiente sul servizio — OLLAMA_FLASH_ATTENTION=1 e OLLAMA_KV_CACHE_TYPE=q8_0 — quella cache scende a 8 bit, e flash attention dà un piccolo guadagno di velocità indipendente. Serve modificare il servizio systemd (quindi permessi da amministratore), non è un parametro che si passa a runtime come num_gpu.
Sul mio server il drop-in sta in /etc/systemd/system/ollama.service.d/override.conf e contiene tre righe:
[Service]
Environment="OLLAMA_FLASH_ATTENTION=1"
Environment="OLLAMA_KV_CACHE_TYPE=q8_0"
Per crearlo: sudo systemctl edit ollama, incollare quelle tre righe, poi sudo systemctl daemon-reload e sudo systemctl restart ollama. Il riavvio scarica i modelli dalla memoria, quindi la prima richiesta dopo sarà lenta perché li ricarica da capo. Per controllare che le due variabili abbiano davvero preso, systemctl show ollama --property=Environment deve mostrarle in coda al PATH.
Il risultato, sullo stesso hardware, stessa sera:
| Prima (f16) | Dopo (q8_0 + flash attention) | |
|---|---|---|
| llama3.2:3b — tetto layer | 18 | 22 |
| llama3.2:3b — velocità al tetto | 6,00 tok/s | 7,72-7,77 tok/s |
| qwen2.5:3b — tetto layer (ctx 4096) | 31 | 33 |
| qwen2.5:3b — velocità al tetto | 8,41 tok/s | 9,54 tok/s |
| Config di allora (qwen2.5:3b, num_gpu 28, ctx 8192) | 7,37 tok/s | 7,54 tok/s |
Il tetto di llama3.2:3b torna esattamente al 22 dell’articolo del 7 agosto — e a una velocità più alta di allora (7,72 contro 7,60). Su qwen2.5:3b il tetto non solo si recupera, va oltre: da 31 a 33 layer.
Un avvertimento su come si legge questa tabella: su quattro righe su cinque cambiano due cose insieme — i flag e il numero di layer, che sale proprio perché il tetto si è alzato. Il salto di velocità che si legge lì è quindi il guadagno del pacchetto, non del solo flag. L’unica riga in cui la configurazione è identica nelle due colonne è quella di allora (num_gpu 28, ctx 8192): è lì che si vede cosa aggiungono i flag a parità di layer.
Prima di scriverlo ho controllato una cosa ovvia: che la KV cache non fosse già quantizzata nei test precedenti, rendendo il confronto un artefatto. Nei log di journalctl, ogni chiamata a llama-server prima del riavvio del servizio mostra --flash-attn off e nessun flag di quantizzazione della cache — comprese tutte le misure della sezione sopra. Dopo il riavvio, ogni chiamata mostra --cache-type-k q8_0 --flash-attn on. Il confronto è pulito.
Una cosa che non ho misurato, e lo dico chiaramente: la qualità delle risposte con la cache a 8 bit. È una compressione lossy — in teoria può perdere precisione su contesti lunghi o compiti che richiedono di recuperare un dettaglio specifico da molto indietro nel prompt. Ho verificato solo velocità e capacità, non la qualità del testo generato.
Nel test sopra le due leve erano attive insieme. Per capire quanto pesa ciascuna, ho rifatto la misura con solo flash attention accesa, KV cache lasciata a f16:
| Config | Tetto layer | Velocità al tetto |
|---|---|---|
| Baseline (nessuna ottimizzazione) | 18 | 6,00 tok/s |
| Solo flash attention | 20 | ~6,8 tok/s |
| Flash attention + KV cache q8_0 | 22 | 7,72-7,77 tok/s |
Le due leve contribuiscono quasi alla pari, due layer a testa. E flash attention da sola non è solo un guadagno di velocità: a 18 layer usa 1793 MiB contro i 1963 del baseline — libera memoria anche senza toccare la KV cache, probabilmente perché usa un kernel di calcolo diverso da quello standard.
Sei giorni dopo: sui modelli nuovi l’auto-fit non era prudente, era assente
Ho ripetuto lo stesso giro di prove su quattro modelli che all’epoca non avevo — la famiglia Qwen3.5 nelle taglie da 0,8 a 9 miliardi di parametri — più il modello che avevo in produzione, rimisurato nelle identiche condizioni per avere un confronto onesto.
Il risultato conferma tutto quello che hai letto sopra, ma su un punto lo peggiora. Più su ho scritto che la stima di Ollama è conservativa, che lascia margine. Guardando i log di caricamento ho trovato questo:
load_tensors: offloaded 0/26 layers to GPUZero. Non «pochi layer per stare larghi»: nessuno. Quella riga è del qwen3.5:2b, un file da 1,9 GiB, e non è un incidente isolato: nella stessa mattinata la scelta automatica ha messo zero layer sulla GPU anche sul 4b e sul 9b, ogni volta che li ha caricati da sola. Eppure il modello ci starebbe: forzando num_gpu a mano, su quello stesso 2b ne entrano ventidue. Il confine, per quel che ho misurato, sta lì in mezzo — il più piccolo della famiglia, 784 MiB, in auto-fit i suoi layer li prende; da 1,9 GiB in su, zero. E zero vuol dire far girare tutto sulla CPU, cioè sui 7,63 GB/s di banda di memoria che avevo misurato nel primo articolo della serie: sono i 3,23 token al secondo della seconda riga della tabella qui sotto.
Ecco cosa costa, modello per modello:
| Modello | Auto-fit | Forzando num_gpu | Guadagno |
|---|---|---|---|
| qwen3.5:0.8b | 14,39 tok/s | 23,65 (24 layer) | 1,64× |
| qwen3.5:2b | 3,23 tok/s | 11,40 (22 layer) | 3,54× |
| qwen3.5:4b | 2,02 tok/s | 3,66 (19 layer) | 1,81× |
| qwen3.5:9b | 1,24 tok/s | 1,56 (7 layer) | 1,26× |
| qwen2.5:3b Q8_0 | 2,75 tok/s | 3,96 (19 layer) | 1,44× |
Cinque modelli su cinque migliorano. Nessuno era già configurato bene.
Tutti questi tetti sono misurati a num_ctx 4096, e a un contesto diverso non valgono. Il contesto occupa VRAM, e la VRAM sono layer: rifacendo lo stesso giro a 8192, sul qwen2.5:3b Q8_0 dell’ultima riga il 19 non carica più — va in errore di memoria, e il tetto scende a 18. Se copiate un numero da questa tabella, copiate anche il contesto a cui è stato misurato.
Una precisazione sull’ultima riga, per non creare confusione con i numeri di prima: è qwen2.5:3b in Q8_0, cioè con i pesi a 8 bit. Tutti gli altri modelli di questo articolo girano nella versione predefinita che scarica Ollama, quantizzata a 4 bit (Q4) — attenzione a non confondere questa con la quantizzazione della cache di cui parlavo poco fa: lì a scendere a 8 bit era la cache del contesto, qui sono i pesi del modello. Pesa il 70% in più — 3,29 GB contro 1,93, e non il doppio come mi aspettavo: il «Q4» predefinito di Ollama è un Q4_K_M da 4,99 bit per peso, non 4,00, perché le K-quant tengono alcuni tensori a precisione più alta. Quindi in VRAM entrano 19 layer invece dei 33 di cui parlavo sopra — e attenzione, quei 33 erano il tetto con flash attention e KV cache q8_0 attive: senza, erano 31. I due numeri non sono confrontabili a parità di condizioni. È la versione che avevo in produzione, e l’ho rimessa nel banco proprio perché il confronto con i modelli nuovi avesse senso: stessa quantizzazione, stesse condizioni, stesso giorno. Quanto pesi davvero quella scelta l’ho misurato in un articolo a parte: fra Q3 e Q8 dello stesso modello ci sono 2,38× di differenza in velocità, e la ragione non è solo il file più leggero da leggere — a parità di VRAM il Q3 fa entrare 24 layer su 29 dove il Q8 ne fa entrare 12.
Su questa riga va anche corretto il «zero» di poco fa: qui l’auto-fit la GPU la usava, sette layer su trentasette. È il motivo per cui in auto-fit fa 2,75 token al secondo invece dei 2,17 che la legge di banda del primo articolo prevede per un file da 3,3 GB girato interamente su CPU. Lo «zero» vale per i Qwen3.5 sopra i due giga, non per tutta la tabella.
Il caso interessante è il 2b: forzandolo, in VRAM entrano ventidue layer, quasi tutti, con 1935 MiB occupati sui 2048 della scheda, e la velocità più che triplica. È lo stesso fenomeno del «modello che entra tutto» di cui parlo più sopra, ma visto dal lato opposto — qui non è il modello a essere troppo grande, è l’auto-fit che si arrende prima di provare.
E si nota una regolarità, dal 2b in su: più il modello è grande, meno l’auto-fit sbaglia. Sotto, sul più piccolo della famiglia, l’auto-fit almeno qualche layer lo carica, e il divario si stringe da sé. Sul 9b, dove in VRAM ci stanno comunque solo sette layer, la differenza fra scegliere bene e scegliere male è un modesto 1,26×. Sul 2b, dove il modello ci starebbe quasi tutto, l’errore costa il triplo della velocità. Il paradosso è che l’auto-fit sbaglia di più proprio nel caso in cui avresti più da guadagnare.
La lezione pratica: lascia margine, non il massimo che hai trovato
La conclusione operativa non è “usa 18 invece di 22” e basta — e nemmeno “attiva la KV cache quantizzata e il problema è risolto per sempre”. È più larga: il numero di layer massimo che entra in una VRAM quasi piena non è una costante. L’ho trovato una volta, l’ho pubblicato, e dodici giorni dopo non valeva più — senza che avessi toccato niente di quello che normalmente si controlla prima di dare la colpa a un cambiamento (driver, versione, riavvio).
Se stai configurando num_gpu a mano su una scheda con poca VRAM di margine:
- Non fermarti all’ultimo valore che ha funzionato: fermati 1-2 layer sotto quello, non sul limite esatto.
- Se il servizio gira in produzione (come il mio log-digest), ricontrolla periodicamente, non solo alla prima configurazione. Un cron che ha sempre funzionato può smettere di partire senza che sia cambiato niente di visibile — né driver, né versione, né un riavvio.
- Il numero che trovi oggi è un dato di oggi, non una specifica tecnica della tua scheda.
Domande frequenti
Perché Ollama non usa tutta la VRAM disponibile da solo?
Perché l’algoritmo che decide quanti layer offloadare (common_params_fit_impl) è volutamente conservativo: preferisce lasciare margine piuttosto che rischiare un errore di memoria a caricamento fatto. Su schede con VRAM abbondante la differenza non si nota; su una scheda da 2 GB, quasi al limite per definizione, quel margine extra può costare dal 50% al 278% di velocità. Con una precisazione importante, che ho scoperto sei giorni dopo: «conservativo» descrive bene quello che fa sui modelli che stanno larghi, ma sui modelli grossi non è prudenza, è resa. Lì l’auto-fit non lascia margine: mette zero layer sulla GPU e fa girare tutto sulla CPU, anche quando forzandolo a mano in VRAM ce ne entrerebbero ventidue. La sezione sui modelli Qwen3.5, più sopra, ha i log e i numeri.
Come si forza num_gpu su Ollama, e come si trova il valore giusto?
Si passa il parametro num_gpu nella chiamata API o nel Modelfile, con il numero di layer da mandare in VRAM. Per trovarlo, si parte da un valore prudente e si sale a step (io uso passi di 4 layer, poi restringo l’intervallo quando mi avvicino all’errore), verificando ogni volta con nvidia-smi quanta memoria resta libera. Una volta trovato il limite, conviene fermarsi 1-2 layer sotto, non esattamente sul valore che ha funzionato l’ultima volta — per il motivo spiegato sopra.
Il numero di layer massimo su una GPU resta stabile nel tempo?
Nella mia esperienza, non è garantito. Su llama3.2:3b il tetto è passato da 22 a 18 layer in dodici giorni, sulla stessa macchina, stesso software, nessun riavvio — senza che riuscissi a identificare una causa esterna. (La causa è stata trovata il 9 settembre 2026: vedi la nota nella sezione «Cosa ho escluso».) Su un altro modello (qwen2.5:3b), misurato lo stesso giorno, il tetto è rimasto stabile. Non è una regola universale, ma è un motivo sufficiente per non trattare un valore di num_gpu come una costante scolpita nella pietra.
La KV cache quantizzata peggiora la qualità delle risposte?
Non lo so, e lo dico chiaramente: non ho testato la qualità, solo velocità e VRAM. È una compressione lossy, quindi in teoria un rischio c’è, soprattutto su contesti lunghi. Se il tuo uso è sensibile alla precisione su prompt molto lunghi, verificalo prima di attivarla in produzione — io per ora l’ho misurata solo su un compito breve.
Conclusione
Quattro risultati.
Il primo è quello che cercavo: un guadagno reale e gratuito, fino a +278%, regolando a mano qualcosa che Ollama sceglie da solo in modo prudente.
Il secondo non lo cercavo affatto: la prova che un numero di tuning trovato oggi può non valere più tra dodici giorni, senza un motivo che sono riuscito a isolare. (La causa è stata trovata il 9 settembre 2026: vedi la nota nella sezione «Cosa ho escluso».)
Il terzo è arrivato provando la leva successiva: la KV cache quantizzata non solo recupera il tetto perso, lo supera — 22 layer su llama3.2:3b, esattamente il valore di dodici giorni prima, e 33 su qwen2.5:3b contro i 31 di prima.
Il quarto è emerso sei giorni dopo, rifacendo lo stesso giro di prove su quattro modelli nuovi: l’auto-fit non sbaglia in modo uniforme, sbaglia di più sui modelli che starebbero quasi tutti in VRAM — cioè esattamente la fascia in cui si muove chiunque abbia una GPU vecchia da 2 GB.
La lezione che lega questo pezzo al resto della serie è la stessa di sempre, con una sfumatura in più: misurare prima di comprare non basta. Bisogna anche essere disposti a rimisurare quello che hai già configurato — perché un consiglio corretto quando l’ho scritto può smettere di esserlo prima che io me ne accorga, se non vado a riguardare.
Nota: le misure principali di questo articolo sono state raccolte il 19 agosto 2026 sul mio homeserver, con i 16 container di servizio attivi — non su una macchina dedicata. Ogni misura è una generazione dallo stesso prompt fisso, con
temperature 0,seed 42,num_predict 200token enum_ctx 4096, e venti secondi di pausa fra un run e l’altro; i token al secondo sono i contatori grezzi di Ollama, non un tempo preso a cronometro. Le ripetizioni non sono uniformi, e vale la pena saperlo: tre run per i valori di auto-fit e per i confini critici (18 contro 19 layer su llama3.2:3b, e ilnum_gpu 29di qwen2.5:3b), un solo run per gli altri punti degli sweep forzati — su mistral:7b una singola generazione supera i 350 secondi. I dati su mistral:7b sono comunque più limitati di quelli degli altri tre modelli: un solo punto pulito in condizione di auto-fit e un solo tentativo di forzatura, fallito subito. La sezione sui modelli Qwen3.5 è del 25 agosto 2026, stessa macchina e stesso metodo, connum_ctx 4096per tutte le misure.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.