Stessa sessione di test del 19 agosto che ha prodotto l’articolo su num_gpu e la sua estensione sulla KV cache quantizzata, ma questa è un’altra leva, non un’altra estensione. Quegli articoli rispondono a “come tuni un file di modello che hai già scelto”. Questo risponde a una domanda precedente: quale file scarichi, prima ancora di iniziare?
Cosa vuol dire “quantizzazione” in pratica
Stesso modello, stessi pesi, salvati con meno bit per parametro. Un modello a 8 bit per peso (Q8) occupa più spazio di uno a 3-4 bit (Q3, Q4) — file più piccolo, meno byte da spostare a ogni token generato, e in teoria (da verificare, non da dare per scontato) qualche perdita di precisione nelle risposte.
Ho scaricato tre versioni dello stesso modello, llama3.2:3b: quella già in uso in produzione (Q4_K_M, 2,0 GB), la più leggera disponibile (Q3_K_M, 1,7 GB) e la più pesante (Q8_0, 3,4 GB).
Il confronto: stesso modello, tre file, ciascuno al proprio limite
Per ogni quantizzazione ho trovato il numero massimo di layer che entra nella VRAM da 2 GB della scheda (stesso metodo dell’articolo su num_gpu: sweep e OOM), poi misurato la velocità a quel limite.
| Quantizzazione | File | Tetto layer (di 29) | % offload | tok/s al tetto |
|---|---|---|---|---|
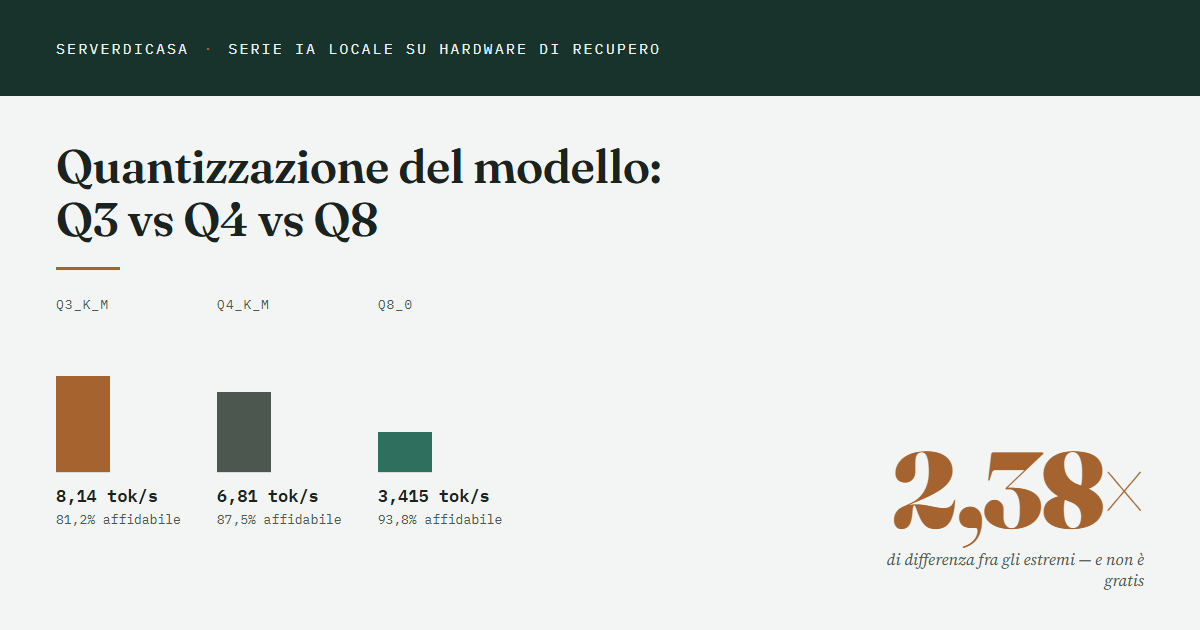
| Q3_K_M | 1,7 GB | 24 | 82,8% | 8,14 |
| Q4_K_M (produzione) | 2,0 GB | 20 | 69,0% | 6,81 |
| Q8_0 | 3,4 GB | 12 | 41,4% | 3,415 |
2,38× tra gli estremi. E il rapporto non è solo l’effetto dei byte in meno da leggere: il file più leggero lascia entrare più layer nella stessa VRAM — 24 su 29 per Q3, appena 12 per Q8, il doppio. Sono due guadagni sovrapposti nella stessa leva, non uno solo. È per questo che il rapporto finale (2,38×) supera il semplice rapporto tra le dimensioni dei file (1,7 contro 3,4 GB, cioè 2,0×).
Il guadagno c’è già prima di toccare num_gpu
Non serve nemmeno configurare niente. Lasciando decidere Ollama da solo, senza forzare num_gpu:
- Q3_K_M: 4,92 tok/s
- Q4_K_M: 4,43 tok/s
- Q8_0: 2,55 tok/s
Q3 è il 93% più veloce di Q8, di default. Un dettaglio che sembra contraddire tutto quello scritto sopra: in questa modalità automatica, Q8_0 usa meno VRAM di Q3 e Q4 (986 MiB contro 1034-1066), non di più. Non perché il modello sia più leggero — è il contrario — ma perché l’auto-fit di Ollama, di fronte a layer più pesanti in MiB, ne carica meno. Stesso comportamento prudente già documentato nell’articolo su num_gpu: lascia margine, anche quando non servirebbe.
Il collegamento con la formula del 31/07 — e il suo limite
Nell’articolo sul processore avevo trovato che tok/s ≈ banda di memoria ÷ dimensione del modello, misurato su CPU pura, un solo regime di banda. Ho provato a ricollegare il dato di oggi a quella formula, calcolando una “banda implicita” (tok/s × dimensione in GB) per ciascuna quantizzazione:
| Quantizzazione | Banda implicita |
|---|---|
| Q3_K_M | 13,84 GB/s |
| Q4_K_M | 13,62 GB/s |
| Q8_0 | 11,61 GB/s |
Q3 e Q4 sono vicini, ma Q8 è visibilmente più basso. Questo non è la stessa riconferma pulita dell’articolo del 31 luglio, e va detto chiaramente: quella misura era CPU-only, un solo regime. Questa qui mescola tre frazioni di offload GPU diverse (82,8% / 69,0% / 41,4%), quindi il numero non descrive “la banda della scheda” — è una media pesata tra la banda della GPU (più alta) e quella della RAM di sistema per i layer rimasti in CPU, con pesi diversi per ciascuna quantizzazione. Non ho rifatto un test CPU-only pulito su queste tre quantizzazioni. È un limite reale di questo confronto, non un dettaglio da nascondere sotto un tappeto di coerenza apparente.
La qualità, misurata — non più solo un rischio dichiarato
Il primo giro di questo articolo si fermava qui: “non ho testato la qualità, solo velocità e VRAM”. Poi ho riusato lo script di affidabilità già costruito per l’articolo sul tool calling — gli stessi 16 casi in italiano e inglese, 2 ripetizioni, temperatura 0 — sulle tre quantizzazioni, stesso ambiente (flash attention e KV cache quantizzata attive, verificato nei log).
| Modello | Affidabilità globale | IT | EN | Falsi positivi |
|---|---|---|---|---|
| Q4_K_M (produzione) | 87,5% | 100% | 100% | 4/8 |
| Q3_K_M | 81,2% | 83,3% | 100% | 4/8 |
| Q8_0 | 93,8% | 100% | 100% | 2/8 |
Il rischio dichiarato prima era reale. Q3_K_M non è solo il più veloce dei tre — è anche il meno affidabile. Perde precisione specificamente sugli argomenti delle chiamate in italiano (83,3% contro il 100% degli altri due), non sulla scelta della funzione, che resta perfetta su tutti e tre. Q8_0 è il migliore anche qui, non solo in teoria: il divario tra 81,2% e 93,8% è abbastanza ampio da non essere rumore statistico, a differenza del pareggio 90,6=90,6 trovato nell’articolo originale tra due modelli diversi.
Una nota a margine, non approfondita: il Q4_K_M di riferimento qui fa 87,5% (4 falsi positivi su 8), contro il 90,6% (3/8) misurato nell’articolo del 17/08 sullo stesso identico modello. Probabile effetto dell’ambiente diverso — allora senza flash attention e KV cache quantizzata attive, oggi con entrambe — ma non l’ho isolato con un test dedicato. Resta una domanda aperta.
E sul modello vero di produzione? Ancora più netto
Tutto quello che ho scritto finora riguarda llama3.2:3b — il modello usato per gli articoli, non quello che girava davvero ogni notte. Il log-digest, quando ho fatto questo test, usava qwen2.5:3b. Ho rifatto lo stesso identico test di affidabilità su tre quantizzazioni di quel modello, e il divario è molto più netto:
| Modello | Affidabilità globale | IT | EN | Falsi positivi |
|---|---|---|---|---|
| Q4_K_M (config precedente) | 84,4% | 83,3% | 75,0% | 0/8 |
| Q3_K_M | 50,0% | 36,4% | 33,3% | 0/7 (2 timeout) |
| Q8_0 | 100,0% | 100% | 100% | 0/8 |
Su qwen, Q3_K_M non è “meno affidabile” — è inutilizzabile. Due chiamate su 32 sono andate in timeout: verificato nei log che non è un errore di misura, il server ha dovuto cancellare la richiesta perché il modello non rispondeva in tempo. Q8_0, all’estremo opposto, è perfetto: 100% su entrambe le lingue.
Ho verificato anche la velocità alla configurazione esatta di produzione (num_ctx 8192): Q4_K_M a num_gpu 28 fa 7,56 tok/s. Q8_0 non ci entra a num_gpu 28 con questo contesto — il suo tetto reale è num_gpu 18, a 3,82 tok/s.
Qui la decisione non è più solo editoriale. Il log-digest gira una volta a notte, senza nessuno a guardare: 3,82 contro 7,56 token al secondo non cambia niente nella pratica — cambia il costo per token, che raddoppia, e l’ho misurato nell’articolo sul costo dell’IA locale. 100% contro 84,4% di affidabilità sì. La notte stessa di questo test, il 19 agosto, ho cambiato la configurazione di produzione: da qwen2.5:3b (Q4_K_M) num_gpu 28 a qwen2.5:3b-instruct-q8_0 num_gpu 18, verificato con un --dry-run e nei log di Ollama che usa davvero quella configurazione.
Una nota aggiunta mentre questo articolo era in coda di pubblicazione. Quella configurazione è durata una settimana esatta: il 26 agosto è cambiata di nuovo. Il digest notturno gira ora su un modello diverso, granite4.2:3b, e il motivo è proprio la riserva che dichiaro qui sotto — nel frattempo l’ho tolta di mezzo con una misura.
Cosa non ho misurato
- Il comportamento senza flash attention. Tutti i test di oggi girano con
OLLAMA_FLASH_ATTENTION=1attivo. Il tetto di layer per ciascuna quantizzazione sarebbe probabilmente diverso (più basso) senza — non ritestato. - Un compito diverso dal tool calling. Il test di affidabilità misura la scelta e la compilazione corretta di chiamate a funzione, non un compito di riassunto o riscrittura come quello del log-digest. Il crollo di Q3 su qwen è comunque un segnale forte — un modello che a volte non termina la risposta in tempo (i due timeout) probabilmente non regge bene nemmeno un riassunto — ma resta un’inferenza, non una misura diretta sul compito reale. Aggiunto dopo, il 26 agosto: la misura diretta adesso c’è, e dice qualcosa che qui non potevo sapere. Ho costruito un banco che ricostruisce dai log veri le finestre che il digest ha davvero visto, e ho confrontato sei modelli sul compito vero — leggere le righe e non perdere quella che conta. Su 27 casi, questo
qwen2.5:3ba 8 bit ne perde due fra le più gravi: una corruzione del database di Pi-hole e una del database di Jellyfin, cioè esattamente i due casi per cui il digest esiste.granite4.2:3bnon ne perde nessuna. Essere il migliore sul tool calling non basta a essere il migliore su un riassunto: il compito va misurato per quello che è, ed è la ragione per cui il modello in produzione oggi è un altro.
Quale scaricare, in pratica
Con il dato di qualità in mano, la risposta cambia rispetto a quello che avrei scritto solo guardando la velocità. Se la VRAM è la risorsa scarsa e il compito tollera qualche errore in più — elaborazioni in background, dove un errore si nota e si corregge — Q3_K_M resta la scelta che spreme di più dall’hardware, ma ora sai quanto costa: un calo di affidabilità reale, non ipotetico, soprattutto sugli argomenti in italiano. Per qualunque cosa tocchi azioni reali — un assistente collegato alla domotica, per esempio — il divario di affidabilità pesa più del guadagno di velocità: meglio Q8_0, o almeno Q4_K_M.
Bonus: le tre leve della giornata insieme
Dopo aver isolato ogni leva per il suo articolo — num_gpu, KV cache quantizzata, e questa quantizzazione del modello — le ho rimesse tutte insieme, stesso hardware, fine della stessa sessione:
| Configurazione | tok/s |
|---|---|
| Baseline di partenza (auto-fit, Q4_K_M, niente ottimizzato) | ~4,0-4,5 |
| Solo quantizzazione Q3_K_M al proprio tetto | 8,14 |
Tutte e tre insieme (Q3_K_M, num_gpu=27, KV cache q8_0 + flash attention) | 9,49-9,51 |
Tetto: 27 layer su 29, il 93,1% del modello dentro 2 GB di VRAM — verificato stabile 3 run su 3, 28 va in errore di memoria 2 volte su 2. Più del doppio della velocità di partenza della giornata, su una scheda del 2014 che a colazione caricava meno della metà del modello.
Le tre leve non competono, si sommano: agiscono su tre punti diversi — quale file scegli, quanto ne entra in VRAM, quanto pesa la cache del contesto. Non c’era motivo per aspettarsi che si escludessero a vicenda, ma vale la pena scriverlo: nessuna delle tre ha eroso il guadagno delle altre.
Domande frequenti
Una quantizzazione più aggressiva peggiora la qualità delle risposte?
Sì, l’ho misurato: su un test di affidabilità del tool calling (lo stesso script dell’articolo sul tool calling), Q3_K_M scende all’81,2% contro il 93,8% di Q8_0, con un calo specifico sulla precisione degli argomenti in italiano. Non è un rischio teorico, è un numero reale — anche se misurato su un solo tipo di compito (chiamate a funzione), non su riassunti o conversazione generica.
Conviene sempre scegliere la quantizzazione più leggera?
No. Il guadagno di velocità è reale (2,38× tra gli estremi), ma ha un costo altrettanto reale in affidabilità: nel mio test, Q3_K_M ha l’83,3% di precisione sugli argomenti in italiano contro il 100% di Q4 e Q8. Su un compito dove sbagliare non costa nulla — un riassunto, una classificazione — il compromesso può avere senso. Su un compito che agisce su qualcosa di reale, meglio partire da Q8 o restare su Q4.
Come scarico una quantizzazione diversa dello stesso modello su Ollama?
Con ollama pull nome-modello:tag-quantizzazione, ad esempio ollama pull llama3.2:3b-instruct-q8_0. Le varianti disponibili si trovano nella pagina del modello sulla libreria di Ollama; non tutti i modelli hanno tutte le quantizzazioni pubblicate.
Conclusione
La terza leva della sessione del 19 agosto, e forse la più diretta delle tre: non serve toccare num_gpu, non serve editare il servizio systemd — basta scegliere il file giusto al momento del download. Il costo non è nel tempo di configurazione, che qui è zero. Il costo è nella qualità delle risposte — e questa volta non è un avvertimento generico: è 81,2% contro 93,8%, misurato.
Nota: tutte le misure di questo articolo sono state raccolte il 19 agosto 2026 sul mio homeserver, con
OLLAMA_FLASH_ATTENTION=1attivo (non il default di Ollama) — le misure di velocità con la KV cache al default f16, i test di affidabilità e il “bonus” finale anche conOLLAMA_KV_CACHE_TYPE=q8_0— e i 16 container di servizio attivi — non su una macchina dedicata. Il test di affidabilità misura solo il tool calling, non un compito di riassunto o conversazione generica.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.