Questo articolo contiene link di affiliazione. ServerDiCasa partecipa al Programma Affiliazione Amazon EU e al programma di affiliazione Hostinger: se attivi un servizio passando dai link presenti in questa pagina, il sito riceve una commissione senza costi aggiuntivi per te. Questo non influisce sulle valutazioni, che restano basate sui test descritti.
Da qualche settimana il mio server legge da solo i log della notte con un modello linguistico che gira in casa, su una GPU da 2 GB che non ho comprato: era già dentro il case. Funziona, e l’ho lasciato lì. Poi è arrivata la domanda che arriva sempre: e quanto mi costa?
Ho attaccato la presa smart e ho misurato. Il risultato più scomodo non è il numero in sé: le stesse risposte, generate da un servizio in cloud, mi costerebbero da cinque a tredici volte meno della sola elettricità che consumo io. Non l’hardware, non il tempo: solo la corrente.
E c’è una seconda cosa, che non stavo cercando. La configurazione su cui ho fatto questa misura costa il doppio per token di quella che avevo misurato due settimane prima, sulla stessa identica macchina, con lo stesso identico prompt.
Sotto ci sono i numeri, il metodo, e la prima misura che ho dovuto buttare.
Il banco di prova: la configurazione che gira davvero, non quella comoda
Le misure di consumo che si trovano in giro sono quasi sempre fatte su una macchina pulita, con il modello che dà i numeri migliori. Questa no. È l’homelab da vecchio PC di sempre, con i suoi sedici container accesi — Jellyfin, Home Assistant, Pi-hole, la suite *arr, i backup — e con il modello che faceva davvero il lavoro notturno quando ho misurato — sul cambio di fine agosto torno più avanti:
- CPU: AMD FX-6350, 3 moduli e 6 thread, del 2013
- RAM: 8 GB DDR3-1600 single channel
- GPU: GeForce GTX 750 Ti, 2 GB di VRAM
- Modello:
qwen2.5:3b-instruct-q8_0,num_gpu 18,num_ctx 8192
Quest’ultima riga conta più di quanto sembri, e la sottolineo perché è il punto in cui questo articolo si stacca da quello che ho scritto due settimane fa. Fino al 19 agosto giravo con lo stesso modello quantizzato a 4 bit e con 28 layer sulla GPU. Poi sono passato a 8 bit e 18 layer — meno layer sulla scheda perché un modello più pesante non ci sta — ed è quella la configurazione su cui è misurato tutto questo articolo. Il motivo del cambio non era la velocità: era l’affidabilità. Sullo stesso modello, a 8 bit, i test di chiamata agli strumenti passavano dall’84% al 100% di risposte corrette, e per un compito che gira di notte senza nessuno a guardare quello conta molto più dei token al secondo.
Di quanti layer convenga forzare su una GPU piccola parlo nell’articolo dedicato; sulla quantizzazione ci torno in un pezzo tutto suo.
Se avessi riusato i numeri di prima avrei scritto un articolo più comodo, e sbagliato di un fattore due. Ci torno.
Sulla tariffa uso 0,20997 €/kWh, che non è il prezzo dell’energia sul mercato ma il totale della mia bolletta diviso i kWh: la stessa che ho spiegato nell’articolo su quanto consuma un homelab acceso 24 ore su 24.
Prima di fidarsi della presa, guarda come campiona
Il consumo lo legge una Shelly Plug S in linea sulla presa del server. La prima volta che ho misurato il gradino dell’inferenza, ad agosto, avevo preso i dati dallo storico di Home Assistant. Il problema è come ci arrivano: lo Shelly non trasmette a intervallo fisso, trasmette quando la misura cambia oltre una soglia. Su venti minuti erano 5-6 letture al minuto, irregolari, con buchi fino a 55 secondi — e durante il carico, che è alto e stabile, ne mandava meno. Una media aritmetica su campioni così sottopesa proprio i tratti stabili.
Stavolta ho tolto il problema alla radice invece di correggerlo a valle: la presa la interrogo direttamente, una volta al secondo, sulla sua API locale.
$ curl -s "http://192.168.68.100/rpc/Switch.GetStatus?id=0"
{"id":0,"source":"init","output":true,"apower":91.3,"voltage":231.5,
"freq":50.0,"current":0.459, ... ,"temperature":{"tC":50.3,"tF":122.5}}(apower è la potenza attiva in watt: è l’unico campo che serve, il resto della risposta l’ho tagliato.)
Un dettaglio che ti risparmia mezz’ora: nella mia documentazione la presa risultava a un altro indirizzo. Il DHCP gliel’ha cambiato in silenzio, e l’ho ritrovata solo cercando il MAC nella tabella ARP. Se la tua non risponde, non dare per buono l’IP che avevi scritto sei mesi fa.
Con un campione al secondo, media pesata e media aritmetica coincidono per costruzione: la statistica smette di essere una scelta da giustificare.
La prima misura l’ho buttata, e vale più del resto
Prima passata: quattro minuti di riposo, sei di carico, tre di ritorno. Il risultato sembrava ragionevole finché non ho guardato il controllo di chiusura — il ritorno a riposo deve ricadere sulla baseline, e invece stava 15,7 W più in basso.
Il colpevole era nei log di Ollama, alle 14:14:38, in piena finestra di riposo:
POST "/api/embed"      (nomic-embed-text)
load_tensors: offloaded 18/37 layers to GPU   (qwen2.5:3b-instruct)
Una query all’assistente RAG via Telegram arrivata mentre misuravo il “riposo”. Ventisette secondi con la scheda al lavoro, con punte al 100%, dentro la finestra che doveva essere di quiete: la baseline è salita a 90,8 W di mediana, contro i 77-83 W dei blocchi puliti misurati mezz’ora dopo. Con un gradino calcolato su quel valore avrei pubblicato un numero più basso del vero, e non me ne sarei accorto.
Non è colpa dello strumento: è un server in produzione, la gente gli parla. La misura va resa capace di sopportarlo. Due contromisure, entrambe nella seconda passata:
- Riposo e carico alternati: R-C-R-C-R invece di una baseline sola. Un evento isolato ne sporca una, e la vedi subito perché è quella che sta fuori dalle altre.
- Contaminazioni rilevate dallo script, non a occhio: durante il riposo il modello è scaricato, quindi VRAM occupata e utilizzo GPU devono stare a zero. Ogni secondo in cui non è così viene marcato, escluso e contato nel report. Se scarto qualcosa devo poterlo dire.
Nella misura buona: zero secondi scartati, zero query all’assistente, zero speedtest del monitoraggio di rete nella finestra.
Il gradino è +91 W, e i due blocchi differiscono di due decimi di watt
Diciassette minuti, cinque blocchi, primi 45 secondi di ognuno scartati come transizione. Tutti i valori sono mediane dei campioni al secondo.
| Blocco | campioni | mediana | p10 | p90 | min | max |
|---|---|---|---|---|---|---|
| riposo 1 | 134 | 77,15 W | 71,8 | 97,3 | 70,6 | 101,8 |
| carico 1 | 205 | 172,10 W | 166,6 | 179,5 | 157,7 | 182,6 |
| riposo 2 | 135 | 82,90 W | 73,1 | 97,3 | 71,0 | 103,3 |
| carico 2 | 203 | 172,30 W | 169,3 | 180,1 | 143,7 | 182,4 |
| riposo 3 | 136 | 81,20 W | 73,5 | 98,0 | 71,7 | 104,5 |
Riposo 81,20 W, carico 172,20 W: il gradino dell’inferenza è +91,00 W.
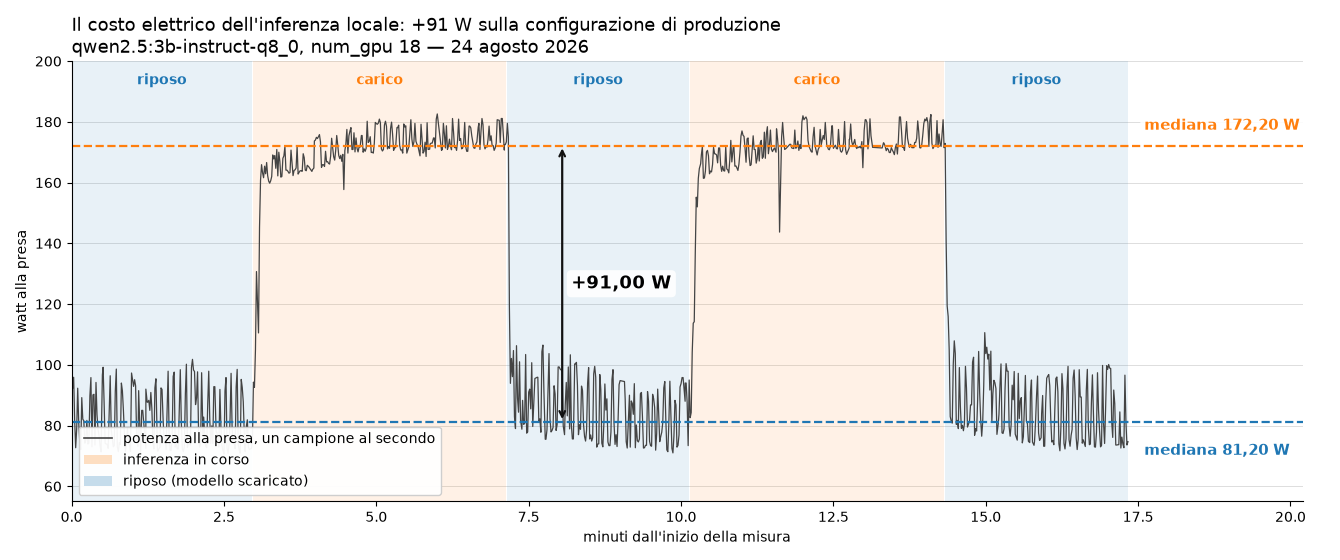
I due blocchi di carico, separati da tre minuti di riposo, differiscono di 0,20 W. È quello il controllo che rende attendibile il resto — l’equivalente del ritorno alla baseline, ma ripetuto.
I blocchi di riposo invece ballano di 5,75 W fra loro e hanno code alte, con il p90 intorno ai 97 W. Non è deriva della misura: sono i sedici container che ogni tanto fanno qualcosa. Per questo riporto la mediana e non la media. Ed è giusto dirti che la scelta, qui, cambia poco: rifacendo il conto con le medie il gradino viene +89,65 W, 1,35 W di differenza. Media e mediana non concordano sulla baseline, ma concordano sul gradino.
Un’ultima onestà sui numeri assoluti: 81 W di riposo sono più dei 74,4 W che ho pubblicato come media di tre settimane. Sono nove minuti di un pomeriggio contro venti giorni di storico, e per i costi annui continua a valere il dato con la base statistica più larga, non questo.
La GPU pesa il quattro per cento
Novantuno watt sono tanti per una scheda il cui limite di potenza dichiarato — quello che riporta nvidia-smi — è 38,5 W. Infatti non sono suoi:
| riposo | carico | delta | quota | |
|---|---|---|---|---|
| Presa | 81,20 W | 172,20 W | +91,00 W | 100% |
GPU (nvidia-smi) | 1,12 W | 5,20 W | +4,08 W | 4,5% |
| Tutto il resto | 80,08 W | 167,00 W | +86,92 W | 95,5% |
Il processore intanto passa dal 7,2% al 49,8% di utilizzo e da 2009 a 3908 MHz: sta correndo alla frequenza massima. Il resto sono VRM, RAM e le perdite dell’alimentatore, che a un’efficienza dell’85% dissipa da solo una tredicina di watt sui 91 — è una stima, non una misura: la presa vede tutto insieme e non sa dividerlo.
Il dato che spiega tutto è l’utilizzo della scheda: mediana 21%, massimo 24%. Nell’articolo sulla VRAM avevo dedotto dai tempi che con l’offload parziale GPU e CPU non lavorano insieme ma si alternano; qui si vede in watt. Con 18 layer su 37 la scheda passa la maggior parte del tempo ad aspettare che la CPU finisca la sua metà del modello.
La conclusione pratica è controintuitiva: su un offload parziale la GPU non è la voce da guardare, né per la velocità né per la bolletta. Quella che paghi è la CPU che le gira intorno.
Da watt a euro: 24,5 joule per token
Il gradino da solo non dice niente finché non lo dividi per il lavoro fatto. Sei richieste identiche da 300 token, tutte completate, velocità fra 3,702 e 3,719 token al secondo — mediana 3,713 tok/s.
| valore | |
|---|---|
| Energia per token generato | 24,51 J |
| Una richiesta da 300 token (80,8 s) | 2,042 Wh = 0,00043 € |
| Un milione di token = 74,8 ore di inferenza continua | |
| → costo marginale (solo il gradino) | 6,81 kWh = 1,43 € |
| → costo pieno (tutti i 172,2 W) | 12,88 kWh = 2,70 € |
Vanno dichiarati entrambi, e la differenza non è un tecnicismo. Il marginale è il numero onesto se la macchina è accesa comunque per altri motivi — nel mio caso lo è, per il media server e la domotica. Il pieno sarebbe quello giusto solo se il server esistesse per fare inferenza e basta.
Nel mio uso reale il conto è ancora più piccolo: il riassunto notturno genera al massimo 260 token, cioè circa settanta secondi di lavoro. Fanno 1,77 Wh a notte, 0,136 € all’anno. Centotrentasette euro per tenere accesa la macchina, quattordici centesimi per farle fare il suo lavoro: un rapporto di uno a mille.
Se hai letto l’articolo sui consumi troverai un numero diverso: lì avevo scritto 0,055 € l’anno. Non è una correzione, è la stessa cosa misurata su un’altra configurazione — allora quella risposta richiedeva trenta secondi, oggi ne richiede settanta. Il costo annuo è più che raddoppiato, e resta comunque una cifra che non esiste.
Il confronto che ho perso
Qui arriva la parte che non mi aspettavo di dover scrivere. Un milione di token generati in casa mi costa 1,43 € di sola elettricità. Gli stessi token, comprati a listino da un fornitore di API, costano questo (prezzi di output verificati il 26 agosto 2026, convertiti al cambio di riferimento BCE del 25 agosto, 1 € = 1,1662 $):
Una precisazione che vale per tutta questa sezione: i prezzi delle API e il cambio euro/dollaro qui sotto sono verificati alla data indicata, non a quella in cui la stai leggendo. Si muovono in fretta — questo articolo stesso nasce da un listino che in due settimane era cambiato di un fattore tre. Il rapporto fra gli ordini di grandezza, invece, si muove molto più lentamente: è quello la parte che regge.
| $/milione | €/milione | rispetto al mio costo marginale | |
|---|---|---|---|
| Locale, marginale (solo il gradino) | — | 1,43 € | — |
| Locale, pieno (tutti i 172,2 W) | — | 2,70 € | 1,9 volte più caro |
| Llama 3.2 3B Instruct — stessa taglia del mio | 0,33 $ | 0,283 € | 5,1 volte più economico |
| Qwen3.7 Flash — un flash recente fra i più economici | 0,13 $ | 0,111 € | 12,8 volte più economico |
Il cloud costa da cinque a tredici volte meno della sola corrente che consumo io. Senza contare l’hardware, la manutenzione, e il fatto che quei modelli sono più capaci del mio.
Devo aggiungere una correzione a me stesso. Quando avevo buttato giù questo confronto la prima volta, avevo annotato Llama 3.2 3B intorno ai 0,10 $ per milione — e non avevo scritto da dove veniva quel numero. Ricontrollando oggi, i due fornitori che lo servono stanno a 0,33 e 0,335 $: un modello da 3 miliardi di parametri è ormai poco richiesto e costa più di un Flash molto più bravo. Il numero vecchio non è verificabile perché non ne ho la fonte, quindi lo butto: da qui in avanti i listini me li segno con fornitore e data.
La stessa macchina, il doppio del costo per token
L’11 agosto avevo misurato lo stesso gradino con la configurazione di allora. Stessa macchina, stesso prompt, stesso numero di token:
| 11/08 — Q4, 28 layer | 24/08 — Q8, 18 layer | |
|---|---|---|
| Gradino alla presa | +86,96 W | +91,00 W |
| Velocità | 7,35 tok/s | 3,713 tok/s |
| Energia per token | 11,8 J | 24,51 J |
| €/milione, marginale | 0,69 € | 1,43 € |
| GPU dentro il gradino | 17,7 W (20%) | 4,08 W (4,5%) |
| Utilizzo GPU medio | 45,6% | 14,8% |
Il consumo istantaneo è quasi lo stesso: quello che si è dimezzato è la velocità. Il file del modello a 8 bit pesa 3,3 GB contro 1,9, e sulla scheda ne stanno 18 layer invece di 28: più byte da rileggere per ogni token, più lavoro sulla CPU, stessa potenza assorbita. Il tempo raddoppia, la potenza no, e il costo per token raddoppia.
È la stessa legge che avevo trovato misurando il processore, vista dal lato della bolletta: a parità di macchina il costo di un token non lo decide quanto consumi, lo decide quanto è grosso il file del modello. Il che significa che scegliere la quantizzazione è anche una decisione economica — ed è il tema di un articolo dedicato, perché fra Q3, Q4 e Q8 non cambia solo la qualità delle risposte.
Una nota aggiunta mentre questo articolo era in coda di pubblicazione. Due giorni dopo aver chiuso queste misure, il 26 agosto, ho cambiato di nuovo la configurazione: il digest notturno gira ora su granite4.2:3b, con num_ctx 4096, num_gpu 33 e num_thread 5, e genera 7,64 token al secondo contro i 3,713 misurati qui.
E qui casca a proposito la regola di cui parla tutto questo articolo, applicata a me stesso: non ho riscalato niente. La tentazione sarebbe dividere i 24,51 joule per token per il rapporto fra le due velocità e chiamarla fatta, ma è esattamente la scorciatoia che questo articolo esiste per smontare. Fra le due configurazioni sono cambiati insieme il modello, la quantizzazione, i layer sulla scheda, la dimensione del contesto e il numero di thread: la ripartizione del lavoro fra processore e GPU è un’altra, quindi il gradino di potenza alla presa va rimisurato, non calcolato. Così l’ho rifatto: stesso script — con l’unica aggiunta di think: False, senza il quale su granite avrei misurato il ragionamento invece del riassunto — stesso schema di blocchi, stessa presa, stesse richieste da 300 token. Ecco cosa viene, a confronto con la misura che hai letto sopra:
| qwen2.5:3b-q8_0 (18 layer, ctx 8192) | granite4.2:3b (33 layer, ctx 4096, 5 thread) | |
|---|---|---|
| Gradino alla presa | +91,00 W | +99,65 W |
| Velocità | 3,713 tok/s | 7,64 tok/s |
| Energia per token | 24,51 J | 13,04 J |
| €/milione, marginale | 1,43 € | 0,76 € |
È l’immagine speculare di quello che era successo ad agosto, e per questo vale la pena guardarla. Allora il consumo istantaneo era rimasto quasi identico ed era la velocità a dimezzarsi, quindi il costo per token era raddoppiato. Stavolta il consumo istantaneo sale — quasi nove watt in più, perché con 33 layer sulla scheda la GPU lavora davvero invece di stare a guardare — ma la velocità raddoppia, e il costo per token quasi si dimezza. Il watt alla presa e il costo del lavoro fatto non si muovono nella stessa direzione, ed è esattamente il motivo per cui questi conti non si riscalano a mente.
Il confronto con il cloud si accorcia ma non si ribalta: da circa 12,8 volte a circa 6,8 volte più caro del flash più economico del listino. Restano valide, invariate, sia la conclusione sia la ragione per cui i numeri della tabella grande più sopra vanno letti per quello che sono — la misura di una configurazione precisa in un giorno preciso, non una proprietà dell’hardware.
Dodici richieste completate, velocità fra 7,58 e 7,70 tok/s, nessun secondo di riposo scartato per attività estranea. Dati grezzi accanto a quelli della misura principale.
Perché questo non è “l’IA locale non ha senso”
Tre cose, prima di tirare la conclusione sbagliata.
Primo: in valore assoluto sono entrambi zero. Il mio uso reale costa quattordici centesimi l’anno. Gli stessi 95.000 token comprati a listino ne costerebbero fra uno e tre. Fra due numeri che sono entrambi rumore, il fattore dieci non decide niente — e chi sceglie in base a quello sta ottimizzando la voce sbagliata del bilancio.
Secondo: nessuno sceglie il locale per risparmiare. Si sceglie perché i dati non escono di casa, perché non c’è un fornitore che cambia listino o ritira il modello che usavi, perché funziona anche senza linea, perché non ci sono limiti di chiamate. Sono ragioni di controllo. Il costo non è mai stato l’argomento, e questi numeri dicono che è meglio non usarlo come tale.
Terzo, ed è il punto pratico: se hai installato un modello in locale per risparmiare, hai sbagliato il conto. Se l’hai installato per le altre ragioni, puoi smettere di preoccuparti della bolletta — perché quello che spendi per farlo lavorare è mille volte meno di quello che spendi per tenere accesa la macchina.
La domanda giusta è un’altra: il server sarebbe acceso comunque?
Tutto il confronto locale contro cloud si riduce a questa domanda, e conviene farsela all’inizio invece che alla fine.
Se il server è già acceso per il media server, i backup, la domotica — allora l’inferenza è praticamente gratis, il costo marginale è quello che hai visto, e la domanda interessante diventa cosa fargli fare mentre è lì.
Se invece dovresti accenderlo apposta, il conto cambia del tutto: ai 137 € l’anno di corrente si aggiunge l’hardware, e il confronto lo perdi su tutta la linea. In quel caso le strade sono due, e nessuna delle due è “un server in casa”: le API a consumo, oppure un piccolo server in affitto. Un VPS entry level su Hostinger parte da 5,49 €/mese in promozione (11,99 € al rinnovo), e ha template pronti per far girare agenti come OpenClaw o Hermes Agent con un clic.
Attenzione però al punto che avevo già trovato ragionando su dove far girare un assistente AI: su quei piani non c’è nessuna GPU. Ci gira l’agente, non il modello. Il modello, da qualche parte, lo paghi comunque — a casa in corrente, oppure a consumo via API, con i tuoi dati che escono.
Domande frequenti
Quanto costa in elettricità una risposta di un LLM locale?
Sul mio hardware, una risposta da 300 token consuma 2,04 Wh, cioè 0,00043 €: circa quattro centesimi ogni cento risposte. Il numero dipende quasi solo da due cose: quanti watt in più assorbe la macchina sotto carico (qui 91) e quanti token al secondo genera (qui 3,7).
Conviene l’IA locale rispetto alle API a pagamento?
Sul costo puro, no: alla mia tariffa un milione di token generati in casa costa 1,43 € di sola elettricità, contro 0,11-0,28 € degli stessi token comprati a listino. Conviene per altro — dati che restano in casa, nessun fornitore che cambia le regole, funzionamento offline. Se il tuo criterio è il prezzo per token, il cloud vince e non c’è partita.
Quanto consuma un LLM locale in un anno?
Dipende da quanto lo usi, ed è per questo che il numero che circola di più (i watt sotto carico) è quello meno utile. Nel mio caso reale — un riassunto dei log a notte — sono 0,65 kWh e 14 centesimi l’anno. Facendolo girare ininterrottamente per un anno intero salirebbe a circa 800 kWh, cioè più di quanto consuma il server per stare acceso: ma è un’ipotesi che non somiglia a nessun uso domestico.
Perché la GPU consuma così poco durante l’inferenza?
Perché con un offload parziale non lavora quasi mai a pieno regime: nella mia misura l’utilizzo mediano è 21% e il massimo 24%. Con solo metà dei layer in VRAM, scheda e processore si alternano invece di lavorare insieme, e la GPU passa gran parte del tempo ad aspettare. È lo stesso motivo per cui l’offload parziale non regala la velocità che ti aspetteresti.
Conclusione
Volevo sapere quanto costa tenere un’intelligenza artificiale in casa. La risposta è: molto meno di quanto pensavo in assoluto, e molto più di quanto costa comprarla a consumo.
Ma il numero che porto a casa non è nessuno dei due. È che la stessa macchina, con lo stesso lavoro, mi è costata il doppio per token dopo un cambio di configurazione fatto per tutt’altro motivo — e me ne sarei accorto solo rimisurando. Se hai cambiato modello o quantizzazione da quando avevi fatto i conti, i tuoi conti sono vecchi.
Il costo dell’inferenza locale, comunque, non è mai stato nel calcolo. È sempre stato nell’interruttore.
Nota: tutte le misure sono state raccolte il 24 agosto 2026 sul mio homeserver, con i sedici container di produzione attivi e senza modificare la configurazione in esecuzione. La potenza è letta alla presa, quindi comprende l’alimentatore; la ripartizione fra GPU e resto si basa su
nvidia-smicampionato al secondo, che può perdere picchi più brevi. La stima delle perdite dell’alimentatore (~13 W) è dichiarata come tale e non è misurata. I prezzi delle API e il cambio euro/dollaro sono quelli del giorno indicato: cambiano, il rapporto fra gli ordini di grandezza molto meno.
Questo articolo fa parte di IA locale su hardware di recupero, la serie in cui provo a far girare modelli in locale su un PC del 2013 misurando tutto: cosa gira davvero, quanto costa tenerlo acceso, a cosa serve. Nell’indice ci sono tutti gli articoli in ordine.